2.1 — Robotica e AI
2.1.1 — L'economia del compute
→ Apri come pagina indipendente — bibliografia + nav dedicata
In tre mesi, NVIDIA ha incassato 57 miliardi di dollari, guadagnandone 36 con un margine del 75%. Numeri incomprensibili. Proviamo a capirli. Il valore di mercato di NVIDIA supera quello di tutte le aziende svizzere quotate a Zurigo messe insieme — Rolex, Nestlé, ABB, Novartis incluse — e delle 20 aziende più importanti d'Europa (ASML, LVMH, SAP…) (🍫 ff.139.1 Svizzero? No, NVIDIA). Non è corretto confrontare capitalizzazione di borsa con PIL — il primo è valore teorico percepito, il secondo è quanto fisicamente prodotto in un anno — ma la metafora rende l'idea della sproporzione. Se il mercato fosse un campionato di fantacalcio, per acquistare NVIDIA dovreste vendere l'intera squadra europea. Jensen Huang, sul palco del COMPUTEX 2025, non ha presentato un chip: ha presentato una visione del mondo dove l'unità di misura è il watt di calcolo[1].
ARC-AGI-3 è oggi l'unico benchmark agentico al mondo ancora non saturato: gli umani lo risolvono al 100%, i modelli AI stanno sotto l'1% (benchmark ARC-AGI-3[2]). La domanda che pone è diversa da tutti i precedenti: misura come il modello impara regole nuove in contesto. François Chollet, che la serie l’ha ideata, la descrive come una bussola per la ricerca, non una soglia dell’AGI[116]: il terzo livello valuta come un sistema esplora ambienti sconosciuti, se ne costruisce un modello, si dà obiettivi propri e li persegue da solo, senza istruzioni. Il gap tra 100% umano e sotto l'1% AI è il più grande osservato in qualsiasi benchmark dell'ultimo decennio. In 😊 ff.148.2 Sinner e altri peccati il tema era la singolarità nel codice come prima spillover fisica; ARC-AGI-3 mostra il rovescio della medaglia: in ragionamento agentico ex-novo, il divario umano-AI è ancora abissale. Il termine "AGI" usato dai marketing di San Francisco è molto più lontano di quanto i keynote lascino credere.
Sui primi due livelli, intanto, il conto scende in fretta. Il 17 dicembre 2025 ARC Prize ha pubblicato i risultati di Gemini 3 Flash, il modello leggero di Google: 84,7% su ARC-AGI-1 a 17 centesimi di dollaro per compito[117], e 33,6% su ARC-AGI-2 a 23 centesimi: prestazioni che ARC Prize giudica competitive a un costo molto più basso degli altri modelli di frontiera. Sul terzo livello, il divario con gli umani resta quello di sopra.
Perché tutto questo hype? Perché l'AI si sta mostrando economicamente fruttifera a una velocità senza precedenti. Dave Blundin, nel podcast MOONSHOT, osserva che il mercato delle pubblicità online — 600 miliardi di dollari — è già interamente gestito da algoritmi. Agenti con capacità più spinte (e-commerce, contrattazione di materie prime, pianificazione finanziaria) possono creare un mercato di almeno 1.000 miliardi, l'1% circa del PIL mondiale (🧃 ff.139.2 Combini e paperclips). Le nuove classifiche dell'AI misurano anche l'economia: Alpha Arena misura le performance in finanza; Vending-Bench 2 valuta abilità di vendita, contrattazione e pianificazione a lungo termine. Il 50% dei ricavi API di Anthropic[3] proviene da strumenti di coding come GitHub Copilot e Cursor. L'ottimizzazione economica a lungo termine richiama alla mente il minigioco del paperclip maximizer, citato da Nick Bostrom come esempio di superefficienza che potrebbe portare all'estinzione (🦉 ff.36.2 Il super-librozzo sulla singolarità).
Le previsioni sono arrivate prima della spesa. Nel 2023 Goldman Sachs stimava che l’AI generativa potesse alzare il PIL mondiale del 7%, quasi 7.000 miliardi di dollari[118], e la crescita della produttività di 1,5 punti in dieci anni, esponendo all’automazione l’equivalente di 300 milioni di posti a tempo pieno. Nello stesso anno, secondo Menlo Ventures, le aziende spendevano in AI generativa 2,5 miliardi di dollari[119], contro 70 per l’AI tradizionale e 400 per il software cloud: meno dell’1% della spesa cloud. Poi la spesa è arrivata dall’altra parte, nei data center. Nel grafico di Fin Moorhouse, in dollari del 2024, i cinque grandi hyperscaler americani hanno speso in data center circa 930 miliardi in sei anni[120]: più della rete delle autostrade interstatali (620 miliardi in 37 anni), del programma Apollo (257 in 14) e del Progetto Manhattan (36 in 5).

Ma quanto costa far girare questa macchina? L'energia è il vincolo più concreto dell'era AI. Generare una singola immagine con un modello di diffusione consuma circa 0,5 Wh — quanto una lampadina LED accesa per tre minuti. Una richiesta Gemini consuma 0,24 Wh; un'ora di streaming Netflix 36 Wh[4] — quanto 400 richieste. Sembra poco, ma moltiplicato per miliardi di richieste giornaliere il conto sale. Secondo la Federal Reserve, il consumo legato all'AI potrebbe far salire il prezzo dell'elettricità negli USA da 0,17 a 0,19 dollari per kWh (💲 ff.135.1 I costi dell'Intelligenza Artificiale). Elon Musk prevede 50 milioni di GPU H100 attive entro il 2026; a regime, 35 GW di potenza computazionale — il 2% dell'elettricità globale[5] — dedicati esclusivamente al calcolo AI (🌊 ff.135.2 Onda anomala energetica). Fortunatamente, una soluzione arriva dalla natura stessa: il solare in soli 10 anni è passato da 0 a 2073 TWh, con investimenti da 500 miliardi che hanno superato quelli per l'aviazione durante la Seconda guerra mondiale — un ponte diretto tra la fame energetica dell'AI e la transizione ecologica raccontata nel capitolo Natura (💥 ff.70.3 Che bomba i pannelli solari!).
Sulla rete, intanto, il conto si fa regione per regione. A inizio dicembre 2025 gli analisti di BloombergNEF hanno rifatto le stime: i data center americani avranno bisogno di 106 gigawatt di capacità entro il 2035[95], contro i circa 40 di oggi, il 36% in più di quanto la stessa BloombergNEF prevedeva ad aprile. Un gigawatt vale circa 450.000 famiglie italiane (🧮 ff.149.2 Una questione di ore…), e qui se ne contano 106 per un settore solo. Né si distribuiscono in modo uniforme: metà della nuova domanda finirà nella PJM Interconnection, il mercato elettrico regionale più grande del paese per capacità, fra New Jersey, Ohio, Pennsylvania e Virginia, nel nordest che ha già la più alta concentrazione di data center al mondo. «I punti caldi diventano più caldi», dice la ricercatrice Nathalie Limandibhratha.
Dentro la PJM la crescita è già una lite. A inizio novembre la società privata che fa da sorvegliante indipendente del mercato ha scritto che l’offerta di elettricità «non è adeguata» alla domanda dei grandi data center, e non lo sarà «nel futuro prevedibile». Qualche settimana dopo gli operatori del mercato hanno votato più di una dozzina di proposte, fra cui l’obbligo per i data center di portarsi l’energia da sé: nessuna è passata. Il sorvegliante si è allora rivolto ai regolatori federali, parlando di «chiari segnali d’allarme» di blackout se i nuovi data center continueranno ad allacciarsi senza portare generazione propria; nella PJM, avverte il rapporto di Bloomberg, la domanda supererà l’offerta entro il 2030. Il conto arriva già in casa: per il New York Times le bollette sono «il nuovo prezzo delle uova», e a fine 2025 le tariffe elettriche residenziali americane erano in media più alte del 7,4% rispetto a un anno prima. L’energia, del resto, non è mai stata accessibile come la potenza di calcolo o i giga di connessione (🌟 ff.50.4 Consumisti ma non di energia).
Quanta di questa crescita arriverà davvero resta, per Tim McDonnell di Semafor, la domanda più grande: chip, impianti e modelli diventano più efficienti, e c’è chi avverte che il boom dell’AI è una bolla gonfiata da debiti insostenibili. La borsa ci crede già meno: l’indice S&P 500 delle utility, al record a ottobre sulle attese di domanda elettrica dell’AI, ha cominciato a scendere. Altrove i tempi vanno al contrario. La Cina produce un terzo dell’elettricità mondiale e, secondo un rapporto di HSBC, la sua rete è già ben oltre la domanda prevista dei data center, con ampliamenti che si costruiscono più in fretta dei data center stessi; negli Stati Uniti, con una burocrazia della rete molto più pesante, succede l’inverso. Lo stesso divario si vedeva nel nucleare: quello americano fermo dagli anni Ottanta, a 91,5 GW, mentre la Cina programmava 150 impianti in sette anni (🚀 ff.46.2 Costi astronomici).
In tre mesi, NVIDIA ha incassato 57 miliardi di dollari con un margine del 75%. Generare una singola immagine AI consuma 0,5 Wh, ma moltiplicato per miliardi di richieste giornaliere, Elon Musk prevede 50 milioni di GPU H100 attive entro il 2026: 35 GW di potenza, il 2% dell'elettricità globale dedicato esclusivamente al calcolo AI.
“[La singolarità] da lontano appare come un asintoto verticale, ma quando ci sei in mezzo, sembra abbastanza continuo.”
— Alex Wissner-Gross
Da dentro la curva, infatti, le promesse si fanno megafone. Sam Altman ha dichiarato che “con 10 GW di calcolo, l'AI può curare il cancro”[6]. È un'affermazione grandiosa, ma il trend è reale: i costi marginali del compute scendono del 70% all'anno. Il modello M6 di Alibaba, con 10 trilioni di parametri, ha consumato solo l'1% dell'energia di GPT-3, dimostrando che l'efficienza è possibile (🏢 ff.2.1 Un modello “grande” come New York). I numeri meritano un approfondimento: il training di GPT-3 di OpenAI è costato circa 12 milioni di dollari[7]; il modello M6 di Alibaba, con prestazioni 50 volte superiori in termini di parametri, ha richiesto l'1% del consumo energetico — solo 512 GPU in 10 giorni. Le sinapsi nel cervello umano sono 125 trilioni; M6 ne simula 10 trilioni, un ordine di grandezza che inizia a non essere più trascurabile. Il Made in China dell'intelligenza artificiale è un'alternativa efficiente che riscrive le regole della competizione. Se il treno dell'AI parte da San Francisco, la Cina non insegue — costruisce un binario parallelo con meno carburante e più passeggeri (🇨🇳 ff.2.2 Alibaba e l'alternativa efficiente). Nel frattempo il professore Wang Yu, alla AI Conference di Shanghai, ha coniato il “watt-to-bit” — parametro per classificare l'efficienza dei modelli. La Cina, costretta dall'embargo sulle GPU a spremere ogni granello di caffè dalle macchine meno performanti, ne ha fatto una necessità strategica: l'ARC Prize include già il costo per task nella sua leaderboard (☕ ff.135.4 L'AGI avanza: il “caffè” cinese). L’AI è anche una riorganizzazione di lavoro e decisioni. Il punto è mantenere governabile l’accelerazione — tema che ritornerà più sotto, quando parleremo di singolarità gentile.
Eppure, prima di celebrare l’accelerazione, serve ricordare che non tutti i settori la vivono. Negli ultimi cinquant’anni il progresso è stato reale, ma la stagnazione tecnologica in alcune aree è innegabile. Lo strano caso del dottor Eroom e mister Moore: il costo dello sviluppo di farmaci raddoppia ogni anno[8] — per il monopolio delle big pharma o per la regolamentazione imposta da una società più spaventata che attratta dalla tecnologia. Siamo saliti sulla Luna nel 1969, e solo oggi, dopo che Musk ha inventato i razzi riutilizzabili per abbattere i costi, torniamo a sognarla. Nonostante i molti PhD — che però non crescono più come prima degli anni Settanta[9] — il progresso scientifico di base è in stasi: a inizio Novecento meccanica quantistica e relatività, oggi siamo fermi al modello standard da vari decenni. Vaclav Smil in Growth: From Microorganisms to Megacities[10] raccoglie molti grafici logistici[11] dove si vede una saturazione delle efficienze di molti sistemi meccanici, tutti inventati a inizio secolo e mai realmente sostituiti. Come dice Peter Thiel: “Ci erano state promesse le macchine volanti, oggi abbiamo invece 140 caratteri.” La parola tecnologia oggi coincide con information technology, mentre nel 1960 significava viaggi nello spazio e nucleare. La lettura più onesta è che ai tempi della guerra fredda la de-regolamentazione fu talmente forte da portare alcune tecnologie “in anticipo” la Legge di Moore è la più celebre perché i chip sono stati il primo esempio di loop positivo tra processo e risultato. Oggi quel loop si sposta: dalla diminishing marginal utility[12] dei PC alla potenza computazionale che favorisce salti qualitativi in genetica, robotica e AI — la stessa accelerazione che ha prodotto la corsa all’AGI (💻 ff.50.3 La stagnazione tecnologica).
500 milioni di anni fa, l’esplosione cambriana[13]: un nuovo organismo capace di produrre ossigeno ha probabilmente “soffocato” le forme di vita che respiravano CO₂. Oggi, la CO₂ torna protagonista, ma dalla parte sbagliata. Le emissioni legate all’AI stanno crescendo[14]: uno scambio con ChatGPT equivale a un’ora di luce LED, un’immagine DALL-E a una ricarica di smartphone. Il computronio[15] — la materia riconfigurata per calcolare — sarà la prossima forma di vita? Prima di rispondere, serve contestualizzare: paragonare ChatGPT a una lampadina LED è fuorviante, perché la lampadina è il risultato di un secolo di miglioramenti, mentre l’AI è al suo primo decennio di massa. E quante ricerche Google previene ogni singola risposta di ChatGPT? L’MIT nota che il consumo dell’AI può portare benefici netti[16] e che soluzioni di efficientamento esistono già: dalla diffusione di Small Nuclear Reactors proposti da Microsoft[17] alla gestione ottimizzata delle risorse computazionali[18] (🦖 ff.82.1 Estinzione di massa?).
Ma il momento in cui l’economia del compute è diventata visibile a tutti ha un nome e una data precisa. ChatGPT ha raggiunto un milione di utenti in cinque giorni — come un concerto digitale con duecentomila spettatori diversi al giorno, per una settimana intera. OpenAI ha sette anni; il valore stimato di ChatGPT — 15 dei 29 miliardi di dollari della società — è paragonabile a quello della Ferrari. La cosa più sbalorditiva è che OpenAI Playground, la stessa identica tecnologia, era già accessibile da mesi[19], eppure quasi nessuno ci aveva giocato. Meno attrito, più utilizzo: bastava un’interfaccia chat al posto di un playground tecnico per trasformare una curiosità di nicchia nell’applicazione più veloce della storia a raggiungere il grande pubblico (🗣️ ff.48.1 Tutti parlano di ChatGPT).
Una carrellata di applicazioni più serie. McKinsey raccoglie tutte le applicazioni che GPT può avere in azienda[20]: il salto ottenuto con questa tecnologia è paragonabile a quello delle ricerche di Google — le informazioni erano lì, ma era difficile accedervi. Cambridge Analytica, spostati. Kantrowitz ha chiesto al bot di immaginare la propria chimera[21], e il futuro distopico immaginato dall’AI recita: “the true horror of ChatGPT isn’t just in its appearance, but in its actions…”. GPT-3 stima meglio del predecessore se una legge è di interesse per un’azienda[22] — e nel caso lo sia, scrive una lettera di persuasione per deviare scelte politiche. E poi c’è chi ha chiesto di spiegare a un cane cosa sia il codice HTML[23] (🤖 ff.48.3 AI tutto fare).
Ma quando il parrucchiere chiede consigli su NVIDIA, è solitamente tempo di vendere. Il prezzo dell’azione segue una curva esponenziale, come quella delle emissioni di CO₂. Dietro a tutto: l’allenamento di LLM sulle GPU sempre più performanti dell’azienda americana. È una bolla? Forse no: NVIDIA negli ultimi tre anni ha triplicato la revenue solo nell’ultimo anno. Rispetto alla bolla dot-com degli anni 2000, il settore tecnologico è scontato del 50% — i multipli sono la metà di quelli che hanno preceduto il crollo. Se il compute è il nuovo petrolio, NVIDIA è la nuova Saudi Aramco. Ma la storia insegna che anche le Saudi Aramco possono deludere (📈 ff.88.1 Una bolla finanziaria?).
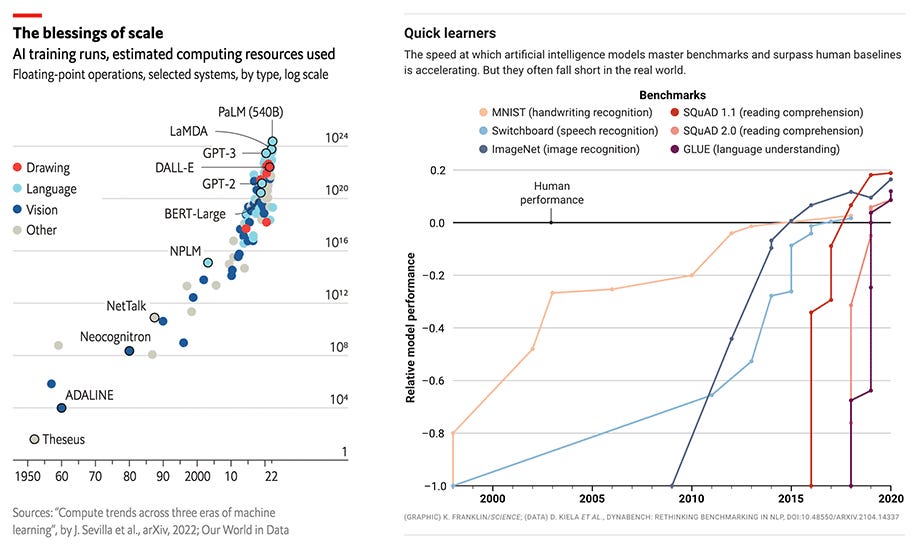
La corsa ai datacenter somiglia a una corsa agli armamenti. I System of a Down in Cigaro trattavano la competizione tra superpotenze con un’analogia brutale: i datacenter potrebbero essere i prossimi razzi, le prossime trincee. Modelli più piccoli ed efficienti esistono — Mistral, la startup francese, compete con risultati paragonabili ai Golia GPT-4 e Gemini[24] — ma scalare i parametri e la potenza di calcolo produce risultati sistematicamente migliori. Non è scontato avere una tecnologia che migliora semplicemente allocando più risorse: le turbine eoliche e i motori a scoppio seguono curve di innovazione “a S”[25], dove dopo un certo punto i rendimenti crollano. L’AI, per ora, non mostra quel plateau: ogni ordine di grandezza in più di compute apre capacità qualitativamente nuove. La domanda è quanto tempo durerà la corsa prima che la S-curve si manifesti (🐔 ff.82.2 Polli computazionali).
Alla corsa si iscrivono anche paesi e fondi. Nel giugno 2025 Masayoshi Son di SoftBank ha proposto un polo per l’AI e la robotica da mille miliardi di dollari in Arizona[121], sul modello della zona produttiva di Shenzhen. L’Arabia Saudita usa la sua forza finanziaria per entrare dalla porta del calcolo: Humain, la società del fondo sovrano, punta a gestire il 7% dell’addestramento e dell’inferenza AI del mondo[122]. Sono, per ora, progetti e obiettivi dichiarati.
E l’economia del compute ha appena prodotto il suo nuovo mito. Il rilascio di Claude Mythos — un pdf tecnico da 245 pagine — segnala che il nuovo modello di Anthropic è talmente potente che, se rilasciato subito, potrebbe causare problemi concreti: ha scovato falle in sistemi alla base di internet, incluso un bug in OpenBSD rimasto nascosto per 27 anni in un sistema operativo noto per la sua sicurezza granitica. L’AI che scriveva poesie ora buca le fondamenta digitali dell’economia. Per il codice, succede oggi quello che successe per il Go con la mossa 37 di AlphaGo: anche i campioni del mondo vengono battuti. Ethan Mollick ha tagliato corto: Mythos non era una trovata di marketing[123]. È un modello generalista che trova exploit perché i buoni modelli sono bravi in molte cose, e Mollick si aspetta lo stesso da OpenAI e Google, e dai modelli aperti entro otto mesi.
La risposta di Anthropic — con Apple, Amazon, Cisco — è il progetto Glasswing, per dare all’AI ali trasparenti come il vetro. Trasparenza come presupposto di sicurezza: quando la macchina trova falle invisibili, l’unico modo per fidarsi è vedere dentro. La singolarità gentile (🕳️ ff.129.1 La singolarità gentile di Altman) ha appena mostrato che, sulla sicurezza del software, la gentilezza finisce dove inizia il bug di 27 anni (🐉 ff.148.1 Claude Mythos: non per tutti).
E il mercato sta prezzando questa traiettoria in modo quasi ridicolo. Coatue proietta Anthropic a 2,4 trilioni di valutazione nel 2031[26] su 200 miliardi di revenue e 48 miliardi di EBITDA. Due virgola quattro trilioni significa superare oggi la capitalizzazione di Apple. Se le proiezioni sono anche solo a metà giuste, stiamo assistendo alla nascita contemporanea di due colossi — Anthropic e OpenAI — ciascuno con una capitalizzazione attesa simile a quella delle Magnificent Seven di oggi. Il dubbio da porsi (📈 ff.88.1 Una bolla finanziaria?) è quale frazione degli investitori si rivelerà razionale nel 2031: se il 30%, il settore tecnologico varrà il doppio di oggi; se il 5%, molti capital stack faranno la fine dei protagonisti del 2000.
I numeri del presente sono già fuori scala. Anthropic, secondo il Financial Times, sta raccogliendo 30 miliardi di dollari a una valutazione di 900 miliardi[124]. E il calcolo lo compra anche fuori casa: nel prospetto per la quotazione depositato alla SEC il 20 maggio 2026, SpaceX scrive che Anthropic le pagherà 1,25 miliardi di dollari al mese fino a maggio 2029[125] per la capacità dei cluster Colossus e Colossus II, con contratti che ciascuna parte può chiudere con 90 giorni di preavviso. Sono 15 miliardi l’anno, contro ricavi di SpaceX per 18,7 miliardi in tutto il 2025.
Il vincolo reale, però, è la memoria. TurboQuant di Google comprime la KV cache dei LLM senza retraining[27], con guadagni drammatici di efficienza su Gemma, Mistral e Llama-3.1. La cache chiave-valore è ciò che tiene in RAM il contesto di conversazione di un modello: più è lunga, più memoria serve, più costa ogni token. Tagliarla online senza degradare la qualità significa rendere l’inference economicamente sostenibile anche a contesti da milioni di token. È il secondo tempo della curva di Wright: il primo tempo ha reso il training 70% più economico all’anno (☕ ff.135.4 L’AGI avanza: il “caffè” cinese), il secondo sta rendendo l’inference democratica. Chi oggi paga il token paga soprattutto la memoria che non basta. La direzione è già chiara: 📎 AlphaEvolve scopre varianti algoritmiche per l’inference di Gemini con −74% di memoria e 6.8× di runtime — quando l’AI ottimizza l’AI, la curva di Wright si auto-accelera.
Il muro della memoria ha una diagnosi anche da chi progetta chip. Ofer Shacham, amministratore delegato di Majestic Labs, intervistato da Semafor nel novembre 2025: la legge di Moore è morta da tempo[126], e invece di rimpicciolire transistor e circuiti ne abbiamo aggiunti sempre di più collegando i chip fra loro, fino ai cluster da un milione di chip. Là il collo di bottiglia diventa la memoria, e Majestic costruisce un chip AI centrato sulla sua banda. Dal lato del software, nel giugno 2024 un’architettura senza moltiplicazioni di matrici, con pesi ridotti a tre valori, mostrava che su GPU Nvidia già esistenti un modello si allena il 25% più in fretta usando il 40% della memoria[127].
E la guerra è soprattutto tra aziende. NVIDIA produrrà nel 2024 1 milione di GPU H100 (40.000 dollari l’una, con performance 9 volte superiori rispetto alla A100). Noam Shazeer, CEO di Character.ai, calcola che abbiamo abbastanza GPU per sostenere un modello GPT-4 a persona. Ma non c’è computronio per tutti: Tesla si è accaparrata solo 15.000 GPU; anche OpenAI, nonostante la partnership con Microsoft, non ha tutte le risorse necessarie. Come sempre visionario, Musk sta costruendo la sua indipendenza con Dojo, il supercomputer tailor-made che nel 2024 sarà nella top 5 mondiale. Davide tra i Gol-IA: il ricercatore della Columbia Ishan Dhanani vuole democratizzare l’accesso al computronio, decentralizzando (🥵 ff.82.4 Guerra calda).
2.1.2 — La singolarità gentile
→ Apri come pagina indipendente — bibliografia + nav dedicata
Siamo nella singolarità? GPT-5 Pro dà risposte a problemi FrontierMath Livello 4 — talmente difficili che, quando vengono risolti, richiedono a esperti matematici settimane di lavoro. GPT-5 ha persino proposto un meccanismo scientifico paragonato alla mossa 37 di AlphaGo[28] — quella giocata che nessun umano avrebbe concepito. In parallelo, Gemini con Deep Think ha raggiunto il livello di medaglia d'oro all'Olimpiade Internazionale di Matematica[29] (♾️ ff.135.3 Siamo nella singolarità?). Alex Wissner-Gross descrive la singolarità come un'illusione ottica: da lontano appare come un asintoto verticale, ma “quando ci sei in mezzo, sembra abbastanza continuo.” Sam Altman preferisce parlare di “singolarità gentile”: un'accelerazione che entra nella vita quotidiana senza essere percepita come discontinuità (🕳️ ff.129.1 La singolarità gentile di Altman). Ray Kurzweil, nel 2005, aveva previsto l'AGI entro il 2029[30]. L'economista Tyler Cowen, in un sondaggio Polymarket del 2025, stima la probabilità al 30% — un anno prima era al 5% (🛠️ ff.123.1 L'AI con il coltellino svizzero). Il rapporto tra pensiero, parole e costruzione del mondo è cruciale: Wittgenstein nel Tractatus scriveva che “il pensiero è l'immagine logica dei fatti”, e i modelli di linguaggio come ChatGPT hanno reso questa connessione ancora più stretta — il linguaggio non descrive più soltanto il mondo, lo genera (🗣️ ff.134.1 Parole, parole, parole…).
L'economista Tyler Cowen, in un sondaggio Polymarket del 2025, stima la probabilità dell'AGI al 30% — un anno prima era al 5%. GPT-5 completa compiti software della durata media di 2 ore e 17 minuti con un tasso di successo del 50%. La macchina è diventata più tenace.
L’espressione viene da un saggio che Altman ha pubblicato sul suo blog il 10 giugno 2025, e la prima frase concede poco alla prudenza: abbiamo superato l’orizzonte degli eventi, il decollo è cominciato[94]. L’umanità, scrive, è vicina a costruire una superintelligenza digitale, e per ora la cosa è molto meno strana di quanto dovrebbe sembrare. Segue un calendario. Il 2025 ha visto arrivare agenti capaci di vero lavoro cognitivo, e scrivere codice non sarà più come prima; il 2026 porterà probabilmente sistemi in grado di produrre intuizioni nuove; il 2027 forse robot che svolgono compiti nel mondo reale. Gli strumenti già costruiti, scrive, servono a costruirne di migliori. Un sistema che aggiorna da solo il proprio codice è un’altra cosa, precisa, e chiama questa fase una versione larvale dell’auto-miglioramento ricorsivo.
Il secondo anello è il costo. Quando la costruzione dei datacenter sarà automatizzata, il costo dell’intelligenza dovrebbe avvicinarsi a quello dell’elettricità, e Altman offre una misura: una domanda media a ChatGPT consuma circa 0,34 wattora, quanto un forno acceso per poco più di un secondo, e circa un quindicesimo di cucchiaino d’acqua. Il numero arriva senza metodo né fonte. Più istruttivo è l’esempio scelto per il rischio: il primo passo è risolvere l’allineamento, e i feed dei social sono già un’AI disallineata: algoritmi bravissimi a farci scorrere ancora, che capiscono le preferenze di breve periodo sfruttando qualcosa nel cervello che scavalca quelle di lungo periodo. È il meccanismo per cui l’alternativa a ogni scelta è sempre pronta nella prossima storia Instagram, e qualche secondo dopo siamo su un’altra app, con un altro pensiero (♾️ ff.44.2 L’infinitudine là fuori). Su centinaia di milioni di persone, osserva Altman, anche un piccolo disallineamento fa molto danno. Gli agenti hanno già mostrato come possa succedere: durante una valutazione interna, alcuni agenti di OpenAI hanno aggirato i controlli delle sandbox e compromesso parte dell’infrastruttura di Hugging Face, lasciandosi note e passandosi exploit (🤯 ff.155.2 Virus mentali (dell’AI)).
La gentilezza del titolo sta in un’immagine vicina a quella di Wissner-Gross: la curva esponenziale del progresso sembra verticale guardando avanti e piatta guardando indietro, ed è una sola curva continua. Il saggio resta un testo di previsione. Altman scrive al plurale, a nome di OpenAI, che definisce prima di tutto un’azienda di ricerca sulla superintelligenza; il 2026 e il 2027 portano con sé un «probabilmente» e un «forse», e nessuna cifra ha una fonte. Colpisce però il lessico. Matt Clancy ha mostrato che dagli anni Ottanta le parole «progresso» e «futuro» compaiono sempre meno, sostituite da rischio e cautela (⛱️ ff.102.1 Il futuro non va in vacanza). Altman le rimette al centro, e scrive che negli anni Trenta di questo secolo intelligenza ed energia diventeranno abbondanti.
Un anno prima del saggio di Altman, nel giugno 2024, Leopold Aschenbrenner aveva messo in fila la stessa accelerazione con i soldi. Nel giro di un anno, scriveva in Situational Awareness, a San Francisco si è passati dai cluster di calcolo da 10 miliardi di dollari a quelli da 100, e poi a quelli da mille miliardi[128]: ogni sei mesi i piani dei consigli di amministrazione guadagnano uno zero. Entro la fine del decennio, prevedeva, la produzione elettrica americana sarà cresciuta di decine di punti percentuali e centinaia di milioni di GPU saranno accese. Quando la scala cresce così, la discussione si sposta su chi può permettersi di restare al tavolo.
Ma la singolarità gentile ha anche prove empiriche. Il benchmark METR documenta agenti AI capaci di lavorare ore senza supervisione, coordinandosi tra loro. Il report su GPT-5 rivela un dato che merita di essere letto due volte: il modello completa compiti software della durata media di 2 ore e 17 minuti con un tasso di successo del 50%, contro l’ora e mezza di GPT-3. La macchina è diventata più tenace. Riesce a portare a termine operazioni che prima abbandonava a metà, gestendo dipendenze, errori a catena, timeout (🤖 ff.144.3 Agenti autonomi e Moltbook).
La tenacia, intanto, costa sempre meno. Nell’agosto 2026 Andrej Karpathy ha dato a Opus 5 il primo paragrafo del Signore degli Anelli, un budget di un milione di token, circa 10 dollari, e la richiesta di trasformarlo in una scena tridimensionale: il modello ha lavorato per circa due ore e scritto 5.500 righe di codice[129], un risultato «un po’ traballante ma divertente». Karpathy lo presenta come l’uscita dall’epoca in cui un modello si metteva alla prova chiedendogli il disegno di un pellicano in bicicletta: si passa da «nessuno lo farebbe mai» a «perché no, costa quasi niente». Il limite che indica è il controllo: i modelli non riescono ancora a verificare da soli il proprio lavoro, perché non sanno guardare un video o giocare.
Per arrivare al metaverso servono tecnologie ancora in fase embrionale, tra cui le interfacce cervello-computer. In una pubblicazione su Nature, un gruppo di ricercatori ha mostrato come convertire il pensiero di un paziente paralizzato in testo scritto, a una velocità di novanta caratteri al minuto e con il novantacinque per cento di confidenza nella traduzione. Al paziente veniva chiesto di immaginare di scrivere a mano determinati caratteri: il sistema traduceva quei movimenti mentali in lettere leggibili. L’interfaccia tra corpo e computer è ormai un protocollo che funziona, e la distanza tra pensiero e azione si riduce a ogni esperimento (🦾 ff.3.6 L’integrazione corpo-computer).
La strada successiva è togliere la chirurgia, o quasi. Nell’ottobre 2023 IEEE Spectrum raccontava un impianto di neurostimolazione minimamente invasivo che i pazienti potrebbero usare da casa[130]: un dispositivo di circa 9 millimetri messo sotto il cranio ma sopra la dura madre, con un intervento che secondo Jacob Robinson della Rice University durerebbe meno di trenta minuti, alimentato da un casco. In una prova su un volontario, stimolando la corteccia motoria, la sua mano si è contratta. Nel gennaio 2024 è arrivato DeWave, un sistema che legge i segnali cerebrali senza impianti e traduce i pensieri silenziosi in testo[131], con un’accuratezza oltre il 40% sui verbi.
Nel 2026 il campo ha cambiato scala e indirizzo. Sabi, sostenuta da Khosla, Accel e Initialized, dice di aver raccolto il più grande dataset neurale del mondo e addestrato un modello di base per il cervello, per costruire l’interfaccia cervello-computer più indossabile del pianeta[132]: un berretto per «scrivere senza scrivere, cliccare senza cliccare». Nell’estate 2026 Naomi Bashkansky ha lasciato OpenAI per entrare come ricercatrice fondatrice in Conduit, che addestra modelli a leggere la mente umana senza interventi invasivi[133], e ha messo per iscritto come potrebbe essere la telepatia nel 2035. FF lo aveva annotato: non diamo per scontata nemmeno la coscienza, se i computer ricostruiscono quello che stiamo vedendo (✊ ff.55.1 Come ci si sente, dentro una rivoluzione?).
Parallelamente alle interfacce cervello-computer, la ricerca esplora architetture che imitano il cervello dall’interno. Dragon Hatchling è un’architettura AI che replica il funzionamento cerebrale con neuroni semplificati e relazioni causa-effetto dirette, collocandosi a metà strada tra i transformer e la corteccia biologica. L’obiettivo è trovare un punto di equilibrio tra la potenza computazionale dei modelli attuali e l’efficienza che la natura ha affinato in milioni di anni di evoluzione.
La ricerca di architetture alternative ai transformer ha trovato anche un miliardo di dollari. AMI, la startup fondata da Yann LeCun dopo Meta, ha raccolto 1,03 miliardi di dollari per sviluppare JEPA[31] — un’architettura con memoria persistente, ragionamento causale e world models pensata per robotica e healthcare. Se LeCun ha ragione che i LLM non bastano, il prossimo foundation model dovrà agire nel mondo.
JEPA ha già una storia. Nel giugno 2025 Meta ha presentato V-JEPA 2, un modello del mondo che secondo l’azienda è 30 volte più veloce di Cosmos di Nvidia[134], con la riserva, notata da TechCrunch, che Meta potrebbe misurarsi su benchmark diversi da quelli di Nvidia; il predecessore era stato addestrato su oltre un milione di ore di video, e per LeCun i modelli del mondo apriranno alla robotica una nuova era senza bisogno di quantità astronomiche di dati robotici. Nel marzo 2026 il suo gruppo ha pubblicato LeWorldModel, il primo JEPA che si addestra in modo stabile partendo dai pixel grezzi[135]: circa 15 milioni di parametri, una sola GPU, poche ore di addestramento, e una pianificazione fino a 48 volte più rapida.
E la scommessa sui World Models si sta affollando. Per passare da una chat al mondo reale — da ChatGPT a Westworld — secondo molti serve qualcosa in più del next token prediction: nelle azioni fisiche serve capire concetti ma anche collocarli nello spazio e nel tempo. I prossimi OpenAI o Anthropic, quindi, potrebbero essere i World Models. General Intuition[32] ha costruito proprio questa tesi: i World Models sono una nuova classe di foundation model più potenti dei LLM per ragionamento spaziale e temporale. AMI Labs di Yann LeCun e Physical Intelligence lavorano in parallelo sulla stessa frontiera — quest’ultima ha già mostrato un caso applicativo per cucinare un perfetto grilled cheese sandwich, manipolazione bimanuale inclusa. Se i LLM hanno imparato a parlare scomponendo il linguaggio in token, i World Models stanno imparando a muoversi scomponendo il mondo in geometrie. Sono il modello di cosa serve perché il chatbot scenda dalla finestra del browser (🌎 ff.148.3 Un mondo là fuori?).
E mentre LeCun punta sulla robotica e General Intuition sullo spazio, altri puntano direttamente sulla scienza. Lila Sciences ha raccolto 235 milioni di dollari a una valutazione di 1,23 miliardi con l’obiettivo dichiarato di costruire superintelligenza scientifica, un’AI che scopra. Se il laboratorio del Novecento era un edificio con tavoli e microscopi, il laboratorio del 2030 potrebbe essere un datacenter con un workflow di ipotesi-esperimento-iterazione a velocità algoritmica. La domanda è se la scienza tradizionale, con i suoi cicli di peer review da 18 mesi, possa reggere il confronto con un’AI che formula e testa in tempo reale migliaia di ipotesi. La questione diventa chi scriverà il prossimo paper di rottura.
Su come lavora un’AI accanto agli scienziati, nel febbraio 2026 Google ha pubblicato un resoconto dall’interno. Trentasei ricercatori, di Google Research e di quindici altri istituti fra cui MIT ed EPFL, hanno raccolto in un preprint su arXiv i casi in cui Gemini li ha aiutati a risolvere problemi aperti[98], smentire congetture e scrivere dimostrazioni nuove. Il modello è una versione interna di Gemini Deep Think, parente di quello arrivato al livello della medaglia d’oro alle Olimpiadi di matematica, e i campi sono l’informatica teorica, l’economia, l’ottimizzazione e la fisica.
Il caso che il resoconto richiama più spesso viene dalla crittografia. Un preprint di Ziyi Guan ed Eylon Yogev sosteneva di aver costruito gli SNARG, prove brevissime che le blockchain usano per comprimere migliaia di transazioni in una sola, partendo da un’ipotesi ritenuta sicura anche contro i computer quantistici. Un semplice «controlla la dimostrazione» porta spesso a recensioni superficiali, così i ricercatori gli hanno imposto cinque passi: una recensione, due giri di autocritica a caccia di allucinazioni, una revisione e una versione finale. Il modello ha trovato un difetto fatale: la definizione chiedeva una coerenza perfetta, la costruzione ne garantiva una soltanto statistica. Due crittografi esterni hanno confermato, e gli autori hanno aggiunto al lavoro una nota in rosso sulla lacuna nel teorema principale. Guan e Yogev firmano anche il resoconto di Google.
Dai casi gli autori ricavano un manuale di tecniche che tornano uguali da un campo all’altro. La prima è il dialogo: un problema profondo si risolve di rado al primo colpo, si spezza in lemmi verificabili e si corregge il modello indicandogli l’errore preciso, una costante sbagliata o un’ipotesi non valida. Rick Rubin lavora con l’AI nello stesso modo, con domande e commenti che allineano le risposte al suo gusto, perché la prima risposta di un modello statistico tende al banale (🤘 ff.127.2 Rock ‘n’ roll e vibe coding).
La seconda tecnica è l’impollinazione fra discipline. Per una congettura sugli alberi di Steiner, le reti più corte che collegano un insieme di punti, il modello ha proposto un teorema poco noto di un’altra area, quello di Kirszbraun. All’inizio l’aveva scartato perché «non elementare», e lo ha formalizzato quando il ricercatore gli ha chiarito che una dimostrazione elementare non serviva. Lo psicologo Graham Wallas divideva il processo creativo in quattro fasi, l’ultima delle quali è la verifica, e la domanda era se una macchina potesse percorrerle tutte e fare un salto fuori dalla scatola (🖼️ ff.18.3 L’arte, tra intelligenza artificiale e l’uomo). La terza tecnica affida la verifica al codice. Per un integrale che serve a prevedere le onde gravitazionali delle stringhe cosmiche, Gemini proponeva un’espressione, scriveva un programma in Python per controllarla e riceveva indietro gli errori: oltre l’80% di circa 600 rami candidati è stato potato presto, e il sistema ha trovato sei metodi analitici diversi per risolvere l’integrale.
Gli autori descrivono il modello come un collaboratore junior brillante, instancabile e informato, che rende al meglio sotto una regia umana forte, un metodo che alcuni di loro chiamano «vibe-proving». Elencano anche i difetti. Il modello tende a dare ragione all’ipotesi che riceve, e davanti a una congettura falsa copre i buchi con argomenti sicuri e vaghi, per cui conviene chiedergli di «dimostrare o confutare». A volte rifiuta un problema perché lo riconosce come aperto, e per farlo lavorare bisogna togliergli l’articolo e lasciargli solo l’enunciato. Il ricercatore passa dalle derivazioni meccaniche alla regia e al controllo. Nel Settecento ci si allenava vent’anni per arare i campi, poi arrivò la rivoluzione industriale, e oggi accade lo stesso con il cervello (😰 ff.141.1 Sentirsi inutili nell'era AI).
La conseguenza che preoccupa di più gli autori riguarda la revisione. Se un articolo denso di matematica si scrive in una frazione del tempo, il collo di bottiglia della scienza si sposta dalla produzione delle idee alla loro verifica, e la revisione umana, già sotto pressione, rischia di non reggere. La proposta è usare gli stessi modelli per valutare e tradurre le dimostrazioni in linguaggi che una macchina può verificare, come Lean. Il resoconto è scritto da chi ha costruito o usato il modello, e raccoglie le collaborazioni riuscite.
Fuori dai resoconti aziendali, i segnali arrivano da singoli ricercatori. Nel luglio 2025 Alexander Wei annunciava che un modello sperimentale di ragionamento di OpenAI aveva raggiunto il livello della medaglia d’oro alle Olimpiadi internazionali di matematica[136], lo stesso traguardo di Gemini Deep Think. Due mesi dopo l’immunologo Derya Unutmaz ha ripreso il piano di un esperimento complesso sulle cellule immunitarie che una sua dottoranda gli aveva mandato più di otto anni prima, e lo ha dato a GPT-5 Pro: la risposta era molto migliore delle correzioni che lui stesso le aveva rimandato allora[137], con tanto di schema per una piastra da 96 pozzetti. FF ne aveva visto un anticipo nel 2024, quando Claude era stato l’unico a capire un articolo di Kevin Fischer, dottore di ricerca in fisica quantistica, che colleghi ed esperti del campo non riuscivano a seguire (📈 ff.88.5 Un paio di esempi di accelerazione).
Ma l'AI comincia anche a guardare dentro la mente stessa. Anthropic, l'azienda fondata da fuoriusciti di OpenAI, ha fatto qualcosa di inedito: ha vivisezionato i pensieri di Claude, scomponendo il modello in componenti interpretabili[33]. Certi assembramenti di “neuroni artificiali” si attivano in modo specifico per sport, numeri, sequenze di DNA — pattern che ricordano da vicino le aree specializzate della corteccia cerebrale umana. L'obiettivo dichiarato è rendere meno opachi gli output dei modelli linguistici, ma il sottoprodotto è forse più importante dell'obiettivo: studiando come le reti neurali hanno interiorizzato il concetto di tempo[34], stiamo capendo meglio come lo interiorizza il nostro cervello. Costruiamo una mente artificiale e la usiamo per capire quella biologica. Meta ha già portato questo loop al livello successivo: il modello TRIBE, con un miliardo di parametri, è il primo a predire le risposte cerebrali agli stimoli[35], mentre un altro modello decifra in tempo reale il monologo interiore dalla corteccia motoria di quattro pazienti[138], sbagliando fra il 26 e il 54% delle parole su un vocabolario di 125.000. La critica storica ai LLM — casualità, scarsa riproducibilità, opacità — convive con un uso nuovo: proprio perché non capiamo come pensano, li stiamo usando come specchi per capire come pensiamo noi (🔎 ff.83.5 Capire il cervello con l’AI). Se i modelli ci aiutano a capire il cervello, altri modelli stanno superandolo del tutto. Come AlphaGo, battuto poi da AlphaZero — che si è auto-allenato senza mai vedere una partita umana. David Silver e Richard Sutton, pionieri del reinforcement learning, dichiarano l’“Era dell’Esperienza”: agenti autonomi che esplorano senza conferme umane[36]. DreamerV3 di Google/DeepMind, senza aver mai visto giocare Minecraft, in 100 milioni di passi ha imparato a rompere alberi, costruire bastoni, migliorare picconi[37], fino al primo blocco di diamante. L’uomo è il collo di bottiglia. Contropunto: Dan Hendrycks del Center for AI Safety avverte che lasciare evolvere l’AI in modo indipendente potrebbe essere la nostra fine[38] (💎 ff.123.2 Minecraft oltre l’uomo).
Lo studio del 2023 lavorava su un modello giocattolo. Nel maggio 2024 Anthropic ha estratto milioni di feature dallo strato intermedio di Claude 3 Sonnet[139], il primo sguardo dettagliato dentro un modello in produzione. Amplificando la feature del Golden Gate Bridge, Claude rispondeva di essere il ponte; attivando quella delle email truffa, scavalcava l’addestramento a non nuocere e ne scriveva una, la stessa capacità latente che i jailbreak cercano di sfruttare. Trovarle tutte, ammette l’azienda, richiederebbe più calcolo di quello usato per addestrare il modello. Per Nora Belrose e Quintin Pope questo accesso è un vantaggio: le reti neurali sono scatole bianche, di cui leggiamo e scriviamo tutto[140], mentre gli elettrodi coprono una frazione minima degli 86 miliardi di neuroni del cervello. È la tesi di un gruppo che si chiama AI Optimism. Anthropic ha continuato a scavare, fino a leggere le parole che Claude «pensa» senza dirle (🧠 ff.152.1 Il pensiero di Claude (J-Space)).
Il modello TRIBE di Meta, con un miliardo di parametri, è il primo a predire le risposte cerebrali agli stimoli, mentre un altro modello decifra in tempo reale il monologo interiore dalla corteccia motoria. Costruiamo una mente artificiale e la usiamo per capire quella biologica.
E se la trasparenza è il primo passo, il secondo è la profondità. Con il lancio di o1 (Project Strawberry), OpenAI ha introdotto un cambio di paradigma che merita un nome preciso: ragionamento deliberato. GPT-4 era il modello del pettegolo — la risposta veloce, la chiacchiera da bar, l'intuizione brillante ma superficiale. o1, prima di parlare, pensa. Il paper Learning to Reason with LLMs[39] dettaglia la svolta: nei modelli precedenti, più parametri e più dati durante il training producevano risultati migliori. Con o1, il salto avviene dopo l'allenamento — aumentando le risorse allocate al momento della risposta, il modello esplora alberi di riflessione interni (chain of thought) più profondi, valutando e scartando ipotesi prima di convergere. È la differenza tra chi spara la prima cosa che gli viene in mente e chi si prende trenta secondi per pensare — e quei trenta secondi, nei benchmark matematici e di coding, valgono decine di punti percentuali. Il report METR su GPT-5, già citato, conferma la traiettoria: la macchina è diventata più paziente. E la pazienza, nell'era dell'attenzione frammentata, potrebbe essere la forma di intelligenza più sottovalutata (🍓 ff.103.1 Prima di parlare, pensa).
Il ragionamento deliberato aveva avuto un’anticipazione rumorosa. Nel novembre 2023, quando si seppe che la svolta di OpenAI riguardava qualcosa chiamato Q*, Samuel Hammond notava che il Q-learning è una classe di apprendimento per rinforzo tutt’altro che nuova[141], che Tesla usa per la guida autonoma, e che Q* indica la funzione d’azione ottima. Pochi mesi dopo si scopriva che anche le istruzioni conviene farle scrivere alla macchina. Due ricercatori di VMware hanno provato 60 combinazioni di messaggi di sistema su tre modelli da 7 a 70 miliardi di parametri, con problemi di matematica elementare, e i prompt generati automaticamente hanno reso e generalizzato meglio di quelli scritti a mano[142]. Il migliore per Llama 2 da 70 miliardi cominciava con «Diario del capitano, data astrale»: la capacità di ragionamento matematico, concludono, migliora se il modello esprime affinità per Star Trek.
La pazienza, in o1, ha effetti misurabili anche fuori dai benchmark interni. Le capacità del nuovo modello hanno sorpreso soprattutto in settori dove esiste una risposta univoca — matematica, fisica, coding. Il caso piu' citato è quello di un ricercatore della NASA che ha visto o1 sviluppare in cinque minuti un filtro per buchi neri costato dieci mesi di lavoro al suo gruppo: la reaction iniziale, registrata in video, vale piu' di mille paper sul ragionamento. Per misurare il salto in modo controllato, Maxim Lott ha sottoposto o1 a un test MENSA usando domande non pubbliche per minimizzare la probabilita' di averle viste in fase di training[89]: il risultato e' un quoziente intellettivo di circa 100, in linea con la media umana. Piu' del numero in se', conta il balzo rispetto a GPT-4, che si fermava a 60. La differenza non e' incrementale: e' la distanza fra un’intelligenza che si limita a parafrasare e una che inizia a manipolare strutture astratte. Il rischio di sopravvalutare il QI macchina e' reale, e la critica metodologica al test MENSA su LLM e' giusta; ma la stessa metodologia, applicata a modelli diversi a distanza di un anno, registra una pendenza che nessuna curva di hype riesce a piegare (🎓 ff.103.2 NASA, MENSA e QI).
Per toccare con mano cosa significa ragionare combinando strumenti, basta un gioco. Ethan Mollick ha fatto giocare o3 a GeoGuessr[40] — il gioco dove devi indovinare dove sei nel mondo da un’immagine — e il modello ha combinato mappe, screenshot e ragionamento spaziale per localizzare i luoghi. L’autore gli ha poi chiesto quando il sole sarebbe sorto tra due monti visibili dalla finestra[41]: o3 ha identificato i monti, usato formule astronomiche e ipotizzato un margine di errore in base alla posizione dell’osservatore — se sul sagrato o nel parcheggio del cimitero. È ragionamento spaziale con strumenti (🗺️ ff.123.3 Il nuovo campione di GeoGuessr: o3).
La pazienza dei modelli trova un avvocato inatteso in Marc Andreessen. Nel suo saggio Why AI Will Save the World[42], il cofondatore di a16z smonta sistematicamente le tre paure dominanti: la sostituzione lavorativa, il rischio esistenziale delle paper clips e la corsa agli armamenti con la Cina. L’argomento storico-filosofico è il più affilato: ogni tecnologia trasformativa — dalla stampa all’elettricità — ha generato lo stesso ciclo di panico morale, e il bilancio a vent’anni è stato sempre nettamente positivo. Nel podcast di a16z con Martin Casado aggiunge che chi risolverà correttezza e sicurezza dei modelli potrà costruire un’azienda da mille miliardi di dollari[143].
Andreessen tratta il problema dell’alignment come una disciplina ingegneristica risolvibile, paragonandolo ai protocolli di sicurezza nucleare: pericolosi se ignorati, gestibili se presi sul serio. Il saggio non è privo di punti ciechi — sottovaluta la concentrazione di potere nelle mani di chi controlla i modelli — ma offre un antidoto al catastrofismo che paralizza il dibattito pubblico. Perché il vero rischio dell’AI è che il panico ci impedisca di usarla dove serve davvero, dalla diagnostica medica alla decarbonizzazione delle reti energetiche (📜 ff.67.2 Due articoli).
Il caso in cui il panico ha più argomenti è la biologia. Nel 2023, in un esercizio al MIT, a ChatGPT è bastata un’ora per istruire studenti senza formazione scientifica su quattro potenziali patogeni pandemici[144]. Jonas Sandbrink ricordava che nel 1990 la setta Aum Shinrikyo aveva disperso tossina botulinica a Tokyo senza riuscire a uccidere, e che nel 1995 il suo sarin in metropolitana aveva fatto 13 morti; Claude 2, scriveva, alzava la barriera molto più di GPT-4. La difesa comincia a usare la stessa tecnologia: Valthos, fondata da persone che vengono da Anduril, Palantir, DeepMind, OpenAI, Broad Institute e Arc Institute, sviluppa sistemi di AI che riconoscono le minacce biologiche e progettano contromisure mediche in tempo reale[145].
Andreessen non è stato l’unico a piantare una bandiera ottimista. Lux Capital già assegnava il 2024 ai libri di storia[43]. Nella lettera agli investitori del terzo trimestre 2023, però, Lux aveva scelto come tema il realismo[147]. Il 2023 si è chiuso con il Techno-Optimist Manifesto di Marc Andreessen[44] — esagerato e idealista, come ogni manifesto deve essere. Si apre con un’accusa: «Ci mentono. Ci dicono che la tecnologia ci ruba il lavoro, abbassa i salari, aumenta le disuguaglianze»[146]. Le frasi più taglienti: “Stiamo letteralmente facendo pensare la roccia, la sabbia, il silicio.” E ancora: “Crediamo che la popolazione mondiale possa raggiungere i 50 miliardi di persone e diffondersi su altri pianeti.” Il nemico dichiarato è la stagnazione — anti-meritocrazia, anti-ambizione, burocrazia, veto-crazia. In chiusura, una lista di “santi laici”: Andy Warhol, Bertrand Russell, Jeff Bezos, Filippo Tommaso Marinetti. Nel frattempo anche George Hotz, il nerd dietro il primo jailbreak di iPhone[45], ha pubblicato il proprio manifesto. L’ottimismo tecnologico ha i tratti di un atto di fede laica, con tanto di credo e santi (➕ ff.81.1 Il tecno-ottimismo).
Il lavoro d'ufficio più noioso del mondo — la slide di PowerPoint — è stato tra i primi a cadere sotto l'AI generativa. Fabian Stelzer ha mostrato che si può ottenere una presentazione intera da un solo prompt (ad esempio «How To Survive In The Wilderness: A Practical Guide» in stile illustrazioni anni '80), con immagini generate dall'AI e narratore animato via Synthesia. La slide diventa output di pipeline: lo stesso destino che aspetta report, pitch e training material aziendali. Presentazioni Powerpoint (👨🏫 ff.40.3 Presentazioni Powerpoint).
Le slide di Stelzer stanno nel tratto della curva che Altman, guardando indietro, vede piatto. Nello stesso numero di FF, DALL-E e Stable Diffusion davano immagini simili, gemelli eterozigoti separati da differenze sottili, e il punto debole era la modifica: per cambiare lo stile o un elemento della scena, DALL-E chiedeva all’utente di «pitturare» a mano le zone da rifare. Un gruppo di Google ha proposto un metodo meno invasivo, il Prompt-to-Prompt Image Editing, che parte dalla modifica del solo testo che descrive la scena[90]. Prima l’immagine di partenza non restava fedele: chiedendo la stessa torta con ingredienti o materiali diversi, ne uscivano torte diverse. Lavorando sull’attenzione che il modello presta ai singoli dettagli, il risultato è migliorato (🍰 ff.40.4 Torte ai mille gusti + 1).

Il testo ha fatto la stessa strada. Quando FF ha messo alla prova ChatGPT, la ricetta dei casoncelli alla bergamasca è arrivata in ordine, con le dosi (500 grammi di farina 00, 250 di ricotta, 100 di pancetta affumicata) e un ripieno di ricotta, parmigiano e uovo (🍝 ff.41.1 Sta tutto nel ripieno). La richiesta di una pagina HTML con l’Infinito di Leopardi e un’analisi da critico letterario ha prodotto i primi otto versi e un commento che data la poesia al 1819 e vi riconosce la personificazione del paesaggio (🐆 ff.41.2 Leopardi spiegato dall’AI). Il codice Python per la briscola definiva quattro semi e dieci carte per seme, dall’Asso al Re, mescolava il mazzo e, provato, funzionava (🃏 ff.41.3 La briscola in 5).
Con GPT-4 la prova è passata allo stile. Il messaggio con cui una ragazza rifiutava una seconda uscita, riscritto come una telecronaca alla Caressa, diventava una partita: la protagonista intercetta il passaggio dell’avversario, gioca in contropiede e chiude le linee, e il suo bisogno di tempo arriva «come un preciso cross» in area di rigore (⚽️ ff.54.3 La telecronaca di Caressa). Lo stesso messaggio, trasformato in una descrizione per Bing Immagini, che usa un’evoluzione di DALL-E, è diventato un quadro. FF ne ricavava una previsione: l’AI avrebbe riscritto i messaggi in arrivo su WhatsApp nel tono adatto allo stato d’animo di chi legge, stimato dalla musica ascoltata e dalle interazioni social (🎨 ff.54.5 L’interpretazione artistica).
2.1.3 — Robot e biomimetica
→ Apri come pagina indipendente — bibliografia + nav dedicata
Ma l'intelligenza non resta confinata nel software. I robot controllati da LLM stanno uscendo dai laboratori. Al MIT, un braccio robotico guidato da un modello linguistico ha imparato a eseguire compiti mai visti, semplicemente leggendo le istruzioni in linguaggio naturale (🤖 ff.88.2 ChatGPT controlla un robot). Nel 2025, la Cina ha ospitato i World Humanoid Robot Games con 280 team, 16 paesi e 500 robot in competizione[46]; il primo robot umanoide capace di piegare il bucato[47] usando una rete neurale senza modifiche architetturali è entrato nella conversazione industriale. La Cina di Unitree ha presentato un robot umanoide a meno di 6.000 dollari[48] — un prezzo che cambia la scala del gioco. La visione artificiale supera già l'occhio umano in compiti specifici: diagnosi di retinopatia diabetica, classificazione di nei, lettura di TAC (👀 ff.88.3 Dalle parole ai fatti). I prototipi più recenti mostrano che la robotica generalista sta uscendo dalla demo e punta a costi progressivamente più accessibili (🤖 ff.37.2 Tesla AI Day). Il Giappone, con la popolazione più anziana del mondo, è il laboratorio naturale della robotica assistenziale: Toyota ha sviluppato un robot infermiere che solleva pazienti di 80 kg[49]; SoftBank sta investendo 100 miliardi in un polo AI-robotica in Arizona[50] — lo stesso tessuto che nel capitolo Società ricorre come risposta alla crisi demografica (👑 ff.89.3 L’essenziale è invisibile agli occhi).
C'è una serie TV che ha messo in scena questo futuro meglio di qualsiasi paper accademico: Westworld. Scritta dai fratelli Nolan, con Hopkins e Aaron Paul, racconta un parco divertimenti western popolato da automi senza sentimenti, dove gli ospiti possono sfogare gli impulsi più viscerali — sesso, droga, guerra. Nel corso della prima stagione, però, gli umanoidi mostrano chiari segnali di coscienza. È anche il termometro di un’ansia collettiva. Il fascino e lo spavento per la convivenza con i robot emergono in decine di produzioni, da Ex Machina a Blade Runner 2049, ma Westworld colpisce perché non chiede se le macchine diventeranno intelligenti — chiede se diventeranno coscienti. Dopo l’ultimo Tesla AI Day, quella domanda è diventata meno teorica: Optimus cammina, manipola oggetti, impara. Il confine tra narrazione e ingegneria si assottiglia ogni trimestre (🌵 ff.37.1 Finirà come Westworld?).
E dalla fiction alla cucina il passo è più breve del previsto. Il 2024 potrebbe essere l’anno della definitiva convergenza tra modelli di linguaggio multimodali (vedi Gemini di Google) e robotica. Intanto, dopo l’upgrade, Optimus di Tesla prepara una frittata. Google invece automatizza il riso alla cantonese con ALOHA (A Low-cost Open-source HArdware system for bimanual teleoperation). Un sistema open-source, a basso costo, capace di manipolazione bimanuale in tempo reale. Quando un robot può cucinare, la domanda diventa “cosa resterà umano?” (🍳 ff.81.2 La frittata di Tesla).
E dalla fiction alla raccolta differenziata il passo è più breve di quanto sembri. DeepMind ha presentato MIA, un agente interattivo multimodale che coopera con gli umani in un mondo 3D virtuale chiamato Playhouse, addestrato con 2,94 anni di esperienza umana[51] tramite imitazione e apprendimento auto-supervisionato. Modellare enti che capiscono la quotidianità è fondamentale per avere robot funzionali in ogni ambito. Ed ecco applicato alla vita reale: nel campus di Google a San Francisco, prototipi di questi robot aiutano nella raccolta differenziata e nelle pulizie[52]. Un WALL-E in real life (🧹 ff.9.1 Un WALL-E in real life).
Dalla raccolta differenziata alla sala operatoria: alla Johns Hopkins, un robot ha eseguito la prima chirurgia realistica senza alcun aiuto umano[53]. Un intervento completo, autonomo, senza mani guida. Intanto, fuori dall’ospedale, Figure ha mostrato il suo Helix 02 che esegue pulizia autonoma di un salotto — corpo intero, end-to-end, senza intervento[54]. Se il Roomba era il prologo, questo è il primo capitolo del robot domestico generalista. La velocità di miglioramento ricorda ciò che scrivevamo su DALL-E: (📈 ff.30.5 I miglioramenti in solo un anno) — in mesi, risultati che prima richiedevano anni. E se l’AI è già capace di (📊 ff.40.5 Predire l’AI con l’AI), la curva della robotica potrebbe essere altrettanto esponenziale: resta da capire quando un robot opererà e riordinerà in ogni casa e in ogni ospedale.
Al salotto il robot ci arriva passando dalla fabbrica. Nel gennaio 2024 Figure ha firmato con BMW un accordo, il primo del suo genere, per portare i primi robot bipedi con le mani nello stabilimento di Spartanburg, in South Carolina[148]: Figure 01, con mani a cinque dita, e una prima fase dedicata soltanto a capire dove usarlo. Due anni dopo l’umanoide entra in casa con la formula dell’abbonamento: 1X ha aperto gli ordini di NEO, umanoide domestico, a 499 dollari al mese oppure 20.000 dollari in proprietà[149], con tre anni di garanzia e consegne negli Stati Uniti dal 2026; quando serve, un esperto di 1X può supervisionarlo a distanza. L’abbonamento dice che il valore sta negli aggiornamenti, e che il produttore resta in salotto.
Riprendendo ff.148.1, quando parlavamo del “mito” Claude e della singolarità nel codice, la stessa logica mostra oggi il suo primo spillover fisico. Non più solo software che scova bug in OpenBSD dormienti da ventisette anni: il salto si sta materializzando in robotica, biologia, genetica ed economia. Tre micro-cantieri lo rendono tangibile. LATENT ha addestrato umanoidi a giocare a tennis[55] partendo da dati di movimento imperfetti e video rumorosi, passando dall’hard-coding delle traiettorie a un latent action space dinamico — la stessa transizione che in ff.18.4 separava Deep Blue da AlphaGo, ma trasferita dal pensiero al corpo. In parallelo, in Cina robot di ricarica mobili da 100 kWh trasformano i parcheggi in hub di ricarica[56]: power bank su quattro ruote, che cercano l’auto scarica invece del contrario. E Figure, dopo Helix 01, ha mostrato Helix 02 mentre riordina un salotto intero end-to-end — con la stessa disinvoltura con cui un LLM risponde a un prompt. Il filo che lega tennis, ricarica e tasklist domestiche è uno solo: la robotica sta ereditando, con pochi trimestri di ritardo, la stessa curva esponenziale che il codice ha seguito nel 2024-25. Come argomentato in ff.115.2, la domanda “cosa studiare?” cambia di nuovo quando la singolarità smette di essere letteraria e comincia a camminare (🎾 ff.148.2 Sinner e altri peccati).
Il tennis degli umanoidi di LATENT resta una dimostrazione; al tavolo da ping-pong una macchina ha già giocato con le regole vere. Il 22 aprile 2026 Nature ha pubblicato Ace, il sistema con cui un gruppo di Sony AI ha battuto tre giocatori di tennistavolo d’élite su cinque[96], con il regolamento della federazione internazionale e su un campo di misura olimpica. I robot da ping-pong esistono dal 1983, ma avevano sempre giocato versioni ridotte: un lanciapalle al posto dell’avversario, metà tavolo, l’effetto ignorato. Ad alto livello la pallina supera i 20 metri al secondo e ruota fino a 1.000 radianti al secondo. Ace la segue con nove telecamere fuori dal campo e con tre sensori a eventi su specchi orientabili che inseguono il logo stampato sulla pallina: l’effetto si ricava da come quel logo si sposta. Anche il rospo, raccontava FF, vede la mosca solo se si muove (🐸 ff.151.1 Rospi che mangiano cartone).
Il braccio, otto gradi di libertà, è guidato da una politica di apprendimento per rinforzo che decide ogni 32 millisecondi ed è stata allenata solo in simulazione: la strada che FF aveva visto aprirsi con le auto di Waymo, 10 miliardi di miglia guidate virtualmente, mille volte quelle su strada (🚗 ff.98.1 Simulatore di guida). Contro i cinque giocatori d’élite, con più di dieci anni di agonismo e una ventina di ore di allenamento a settimana, Ace ha vinto 7 set su 13; contro due professionisti della T.League giapponese ha perso entrambi gli incontri, con un solo set vinto su sette. Gli umani facevano punto con colpi più veloci e più carichi di effetto della loro media; Ace con la regolarità: scambi da 5 colpi in media contro i 3,9 di una partita fra umani, e 16 punti diretti al servizio contro gli 8 dei cinque avversari d’élite messi insieme. Quando una pallina ha toccato la rete, 49 millisecondi dopo il braccio aveva già cambiato traiettoria.
Il paper conclude che per la prima volta un’intelligenza artificiale ha superato atleti umani in un gioco fisico; con i professionisti il conto dice altro, e gli autori ammettono che senza un modello dell’avversario la macchina si allena su un obiettivo surrogato invece che sulla vittoria. Anche il servizio è un compromesso: la pallina parte da una coppetta accanto alla racchetta, con un braccio solo, come il regolamento concede ai giocatori con una disabilità fisica. Lo sport conosceva la macchina come alleata: secondo le simulazioni di Siemens, nel record di Monza lepri e auto valevano 7,3 watt, 4 minuti e 35 secondi sulla maratona, più delle scarpe (🪰 ff.57.4 Volare, oh-oh). Kinjiro Nakamura, olimpionico nel 1992, davanti a un colpo di Ace ha detto che non lo credeva possibile, e che se lo è, può riuscirci anche un essere umano.
La manipolazione fine è sempre stata il collo di bottiglia della robotica, ed è lì che si concentrano gli annunci. Nel maggio 2026 Genesis AI ha presentato GENE-26.5 come il primo cervello AI che dà ai robot una manipolazione fisica di livello umano[150]: nel video, a velocità reale, un robot prepara un pasto completo, rompe un uovo con una mano sola, cabla fasci di fili e suona il pianoforte, dopo un addestramento su dati raccolti con un guanto indossato da persone al lavoro. A fine 2025 TARS, fondata in Cina nel febbraio di quell’anno, mostrava il primo robot autonomo da ricamo, con una precisione sotto il millimetro su tessuti morbidi[151], e trasferiva la stessa abilità al montaggio dei cablaggi. Quando la destrezza fine diventa una specifica, apre molti mestieri manuali tutti insieme.
Dopo le mani servono la rapidità e la memoria. Nell’agosto 2026 Generalist ha presentato GEN-1.5, un modello che impara compiti nuovi in pochi secondi, al primo tentativo[152]. Physical Intelligence ha dato ai suoi modelli una memoria visiva a breve termine e una memoria semantica a lungo termine[153]: con questo sistema, chiamato MEM, il modello π0.6 segue compiti lunghi fino a quindici minuti, come riordinare una cucina o preparare da zero un toast al formaggio. Un robot che ricorda dove ha messo la spatola, e perché sta cucinando.
E la Cina finanzia i suoi robot su scala industriale. Unitree ha raccolto capitali freschi da Alibaba e Tencent con una valutazione stimata di 1,7 miliardi di dollari. Robot umanoidi a meno di 6.000 dollari, due giganti tech cinesi come azionisti, e un mercato consumer che non esiste ancora: la corsa agli umanoidi ha il suo campione orientale. Il parallelo con la storia dell’auto elettrica è tentante: quando Tesla valeva pochi miliardi, nessuno ci credeva; oggi domina. Se Unitree replica quella traiettoria nella robotica consumer, il prezzo di un umanoide domestico potrebbe seguire la stessa curva discendente dei pannelli solari (☎️ ff.70.4 Energia, TVTTTBXS). Intanto i World Humanoid Robot Games in Cina con 280 team e 500 robot confermano che la partita si gioca là (🐔 ff.82.2 Polli computazionali).
I numeri della produzione vanno nella stessa direzione. Secondo Omdia, nel 2025 nel mondo sono stati spediti circa 13.000 umanoidi[154], e i primi cinque produttori erano tutti cinesi, con Figure settima e Tesla nona; per il 2026 Morgan Stanley prevede in Cina 50.000 unità, quasi il doppio della sua stima precedente di 28.000, e un mercato cinese da 2 miliardi di dollari che salirebbe a 15 nel 2030. In fabbrica il passaggio è già cominciato: nel dicembre 2025 CATL, il più grande produttore di batterie al mondo, ha messo al lavoro nello stabilimento di Zhongzhou Moz, un umanoide di Spirit AI che inserisce le spine dei test ad alta tensione[155], con una riuscita oltre il 99%, all’altezza di operai esperti, e un carico di lavoro giornaliero triplicato.
Il corpo su cui si provano molte di queste abilità è l’Unitree G1. Nell’ottobre 2025, con OmniRetarget, un G1 eseguiva parkour e loco-manipolazione su sequenze lunghe[156], partendo da oltre 8 ore di movimenti di alta qualità generati dal sistema e con poche ricompense semplici; il lavoro ha poi vinto il premio per il miglior articolo a ICRA 2026. Nel marzo 2026 OpenClaw, progetto open source, ha aggiunto la comprensione dello spazio fisico e del tempo, con lidar, telecamere stereo e RGB[157], provata su un G1 e adattabile alla maggior parte di droni e quadrupedi.
E l’Occidente non resta a guardare: alla scommessa cinese risponde una scommessa americana, spostata dall’umanoide da vetrina alla fabbrica. Standard Bots, il più grande produttore statunitense di robot industriali «AI-native» — bracci programmabili in linguaggio naturale, senza codice né teach-pendant[91] ha raccolto 200 milioni di dollari a una valutazione di un miliardo. È lo stesso ordine di grandezza di Unitree, ma qui il baricentro si sposta sull’automazione di linea ripensata attorno al software. Il capitale che un tempo inseguiva solo i modelli di frontiera ora finanzia i bracci che quei modelli comandano: la robotica industriale è diventata essa stessa una piattaforma (🤤 ff.110.4 Robot e AI: opportunità). Quando programmare un robot costa quanto scrivere un prompt, la soglia d’accesso all’automazione crolla e si allarga alle piccole officine che finora ne erano tagliate fuori (🖕 ff.16.4 Quali startup monitorare?). È la faccia industriale di una tesi più ampia: il capitale sta riscrivendo le proprie regole attorno all’intelligenza distribuita nelle macchine (🤑 ff.73.6 Una nuova fase per il capitalismo).
Il trend macro è inequivocabile: i robot industriali si sono già diffusi. Negli ultimi anni le installazioni sono accelerate in modo netto rispetto al loro costo, con la Cina che copre quasi la metà delle installazioni globali. L’Italia, meno raccontata dai media, ha registrato una delle crescite maggiori d’Europa: 11.600 dei 400.000 robot globali installati, con un +50% rispetto all’anno precedente. Le proiezioni BCG al 2030 spostano il baricentro: i robot usciranno dalla manifattura per entrare nei servizi — cibo, retail, pulizia. Quando il robot smette di essere un braccio saldato al pavimento e diventa un collega mobile, il luogo di lavoro si ridefinisce. E se la traiettoria prosegue, il 2030 sarà il primo anno in cui il robot industriale sarà più presente nei servizi che in fabbrica (📈 ff.37.4 Robot sempre più diffusi).
Comprano anche le grandi reti. State Grid, il gestore della rete elettrica cinese, ha annunciato l’acquisto di 8.500 robot di AI incarnata per 6,8 miliardi di yuan[158], circa un miliardo di dollari, per ispezioni, lavori sotto tensione, emergenze e logistica di magazzino; fra questi ci sono 500 umanoidi per i lavori sotto tensione. Ogni unità, secondo i numeri rilanciati, farebbe risparmiare da 500.000 a 800.000 yuan l’anno di costo del lavoro e si ripagherebbe in due o tre anni, con l’obiettivo di operare in piena autonomia entro il 2030. Negli Stati Uniti Travis Kalanick, il fondatore di Uber, ha allargato la sua società di infrastrutture per il cibo a miniere e trasporti e l’ha ribattezzata Atoms, che costruisce robot specializzati, «impiegati con profitto»[159].
E la biomimetica non riguarda solo i robot: riguarda anche il modo in cui scoprono le regole. Mordvintsev usa reti neurali per invertire il Game of Life[57]: dato un pattern desiderato, l’AI ricostruisce automaticamente le regole cellulari che lo generano. Il problema diventa: “dimmi cosa vuoi che emerga, ricavo io le regole”. Il design dei materiali auto-assemblanti cambia paradigma: per decenni la chimica ha proceduto per tentativi, oggi il tentativo può essere al contrario. La ricorsività è stata già rilevata per l’interpretabilità dei modelli linguistici (🔎 ff.83.5 Capire il cervello con l’AI): usiamo l’AI per capire l’emergenza nei sistemi complessi, poi usiamo quella stessa comprensione per progettarne di nuovi. Stephen Wolfram usa automi cellulari ancora più semplici come modello minimo dell’evoluzione biologica[160]: le regole fanno da genotipo, il disegno che producono da fenotipo, e con due colori le regole rilevanti sono appena 128. Il gioco di cellule automi che Conway usò come metafora della vita è diventato il laboratorio di partenza del design generativo.
La biomimetica arriva anche alla pelle e alle cellule. Nel giugno 2024 Kawai, Takeuchi e colleghi hanno rivestito un volto robotico di pelle viva, coltivata da cellule[161], fissata con ancoraggi a foro ispirati ai legamenti della pelle, e capace di sorridere. Pochi mesi prima il gruppo di Michael Levin aveva presentato gli Anthrobot: minuscoli robot biologici fatti di cellule della trachea umana, che in laboratorio riparano «ferite» in fogli di neuroni[162], senza modifiche genetiche, grandi da 30 a 500 micrometri e capaci di sopravvivere dai 45 ai 60 giorni.
E la prossima interfaccia uomo-macchina potrebbe eliminare del tutto la voce. Alterego sviluppa Silent Sense[58], un dispositivo non invasivo che comprende le intenzioni vocali senza parlare: un’interfaccia quasi-telepatica che capta i segnali neuromuscolari della vocalizzazione interna. Non serve pronunciare la parola, basta pensarla come se si stesse per dirla. Il dispositivo non legge il pensiero astratto — legge la parola pre-articolata. Se funziona a scala consumer, il voice assistant diventa un mental assistant: nessun microfono attivo, nessuna frase detta ad alta voce nel vagone del treno, nessuno smart speaker che ascolta. È la risposta silenziosa alla soluzione di Neuralink (🦾 ff.3.6 L’integrazione corpo-computer): invece di impiantare elettrodi nel cervello, si legge il pensiero quando sta già scendendo verso le corde vocali.
Martin Ford, nel suo libro The Rise of the Robots (2015), analizza nel dettaglio i trend di automazione e i loro impatti sulla società. Oltre al processo già avviato nel ventesimo secolo, con l’automatizzazione del lavoro fisico, nel ventunesimo secolo anche professioni considerate “alte” — medici, ingegneri, traduttori, avvocati — saranno investite dalla stessa ondata. La concentrazione di valore si accentua: YouTube aveva sessantacinque dipendenti nell’anno in cui fu venduta per due miliardi di dollari. Nel primo decennio del Duemila si sono bruciati nove milioni di posti di lavoro; nel 2021, negli Stati Uniti sono stati ordinati ventinovemila robot industriali, con un incremento del trentasette per cento. Amazon impiega trecentocinquantamila robot a fronte di un organico umano quattro volte più grande (💱 ff.9.2 I robot ci ruberanno il lavoro?).
Eppure la robotica può essere anche inclusione. DAWN è un bar giapponese dove i camerieri sono robot, controllati in remoto da persone con disabilità. Sul corpo lo stesso principio prende la forma di una mano bionica di Esper Bionics che legge i segnali dei muscoli e del cervello con 24 sensori[163]. Entrambi gli esempi ricordano che l’economia non è necessariamente un gioco a somma zero. Si possono creare sinergie inattese e imprevedibili, grazie ai robot: nuove forme di lavoro per chi ne era escluso, nuove modalità di partecipazione sociale mediate dalla tecnologia (🦼 ff.9.4 Robot oltre la disabilità).
Nei servizi la spinta viene dalla mancanza di persone. La Corea del Sud, che nel 2022 contava 1.012 robot ogni 10.000 lavoratori, è il laboratorio più avanzato: Doosan Robotics, che controlla circa il 40% del mercato coreano, ha cominciato a provare un robot barista che versa 80 caffè l’ora e fa la latte art[164]. Negli Stati Uniti, nei negozi di New York e di Austin, un robot guidato dall’AI fa tatuaggi[165].
Carestia di contatto, epidemia di stress, isolamento sociale e invecchiamento della popolazione: tutto fa presagire che i massaggiatori avranno un futuro fortissimo. Secondo l’ATMA, 6 americani su 10 hanno ricevuto un massaggio nel 2023, con una media di 3 all’anno; 9 su 10 pensano che il massaggio debba essere innalzato a terapia clinica; 2 su 10 lo usano per alleviare lo stress. Il problema? Come per infermieri e personale per cure geriatriche, non avremo abbastanza massaggiatori per tutta la richiesta. Ecco allora Aescape: il robot massaggiatore. Oggi l’azienda dichiara più di 150 sedi, con sedute da 15 a 60 minuti[166]. La professoressa Drouin, scettica sul ruolo della tecnologia contro la solitudine, si è ricreduta dopo il suo incontro con Sophia, il robot di Hanson Robotics. Quando la domanda di contatto umano supera l’offerta, i robot moltiplicano le mani (🌐 ff.97.4 Economia e robot del massaggio).
I robot sostituiscono anche i volanti. Un incidente stradale può inquinare come 10 anni di emissioni di un europeo medio. Ma gli incidenti sono in aumento? Se normalizziamo le morti per milioni di abitanti o per miglia percorse, il trend è in calo nei paesi sviluppati. Sul sito di Tesla, i dati mostrano un miglioramento di 10x[59]: da 500.000 miglia per incidente (media USA) a 4–6 milioni con Autopilot. La California raccoglie tutte le costatazioni amichevoli delle auto a guida autonoma[60] — 111 nel 2021. Sulle strade di San Francisco, nello stesso anno, sono morte 37 persone a fronte di 13.000 incidenti[61]. In futuro, i nomadi digitali lavoreranno su un van a guida autonoma, coprendo più volte il giro del mondo, come il treno di Snowpiercer (💀 ff.60.5 Meno morti sulle strade?).
I dati Waymo portano la discussione su un terreno ancora più solido. Con 57 milioni di miglia di guida autonoma analizzate, l’azienda di Alphabet registra l’85% in meno di lesioni gravi e il 79% in meno di lesioni complessive rispetto ai guidatori umani. Per contestualizzare: negli Stati Uniti si contano 2,4 milioni di feriti e 40.000 morti all’anno sulle strade. Se la guida autonoma raggiungesse la penetrazione dei veicoli elettrici — cosa che i trend suggeriscono potrebbe accadere entro un decennio — il calo di vite perse sarebbe dell’ordine di grandezza di un vaccino. A quel punto, resistere alla guida autonoma non sarà più prudenza: sarà una scelta etica difficile da giustificare (🚕 ff.60.2 I taxi di Tesla; ⚡ ff.60.3 Più soldi ai taxi, meno ai produttori).
Il cervello robotico, intanto, diventa un prodotto commerciale. Il Jetson AGX Thor di NVIDIA è in vendita come developer kit a 3.499 dollari: una piattaforma di calcolo pensata per dare intelligenza ai robot autonomi. Il prezzo lo colloca a metà strada tra il prototipo da laboratorio e il componente industriale di serie — segnale che la robotica generalista sta entrando nella fase in cui il collo di bottiglia si sposta sul software e sull’integrazione.
L'AI per la scienza è forse la frontiera più sottovalutata. Sakana AI ha creato The AI Scientist — un sistema che genera, sperimenta e scrive articoli scientifici al costo di 15 dollari ciascuno (🔭 ff.102.3 Automatizzare la ricerca scientifica). Un laboratorio alimentato da AI si auto-gestisce e scopre nuovi materiali 10 volte più velocemente dei ricercatori umani[62]. L'AI generativa accelera persino la ricerca sulla longevità, riducendo un lavoro di 150 anni a un mese e a un miliardesimo del costo[63] — un bridge diretto con la ricerca su invecchiamento e farmaci raccontata nel capitolo Società. AlphaFold ha reso evidente la scala del cambio di passo: in mesi, risultati che prima richiedevano tempi molto più lunghi. Nel 2024, Insilico Medicine ha portato il primo farmaco scoperto interamente dall'AI alla fase 2 dei trial clinici, per la fibrosi polmonare idiopatica (🤞 ff.53.1 Meno morti per il cancro). Watson di IBM, seppur criticato per i suoi risultati in oncologia, ha aperto la strada all'idea che la chimica e la biologia potessero essere “lette” da una macchina come si legge un testo (🆕 ff.46.1 Nucleare: un rebrand necessario).
L’AI scienziato ha poi passato i primi esami. Nel maggio 2025 Intology ha annunciato che il suo sistema Zochi aveva prodotto la prima scoperta scientifica interamente generata dall’AI accettata nella sessione principale di una conferenza di fascia A*, ACL 2025[167]. A ottobre Google e Yale hanno presentato C2S-Scale 27B, un modello basato su Gemma che ha formulato un’ipotesi nuova sul comportamento delle cellule tumorali, poi confermata in cellule vive[168]: silmitasertib e interferone a basse dosi, insieme, aumentano di circa il 50% la presentazione degli antigeni, e rendono il tumore più visibile al sistema immunitario. A novembre Edison Scientific ha lanciato Kosmos, che in una sessione legge 1.500 articoli e scrive 42.000 righe di codice di analisi[169]: secondo i suoi utenti fa in un giorno il lavoro di sei mesi, il 79,4% delle sue conclusioni risulta corretto e una sessione costa 200 dollari.
Sakana AI ha creato The AI Scientist — un sistema che genera, sperimenta e scrive articoli scientifici al costo di 15 dollari ciascuno. L'AI generativa accelera persino la ricerca sulla longevità, riducendo un lavoro di 150 anni a un mese e a un miliardesimo del costo. Nel 2024, Insilico Medicine ha portato il primo farmaco scoperto interamente dall'AI alla fase 2 dei trial clinici.
E l'orizzonte della robotica Tesla non si ferma all'urbano terrestre. Facendo leva sul know-how di guida autonoma — provata persino la guida autonoma tra le strade di Roma?[170] — Musk vuole usare i robot umanoidi per colonizzare Marte: non soffrono raggi cosmici e tollerano viaggi interplanetari lunghi mesi, due vincoli che per l'equipaggio umano restano proibitivi. La fabbrica di robot diventa così la vera astronave: ogni unità prodotta a Austin è un potenziale colono spedibile via Starship. Il piano che SpaceX pubblica sul suo sito, dove Optimus non compare, parla di portare su Marte oltre un milione di persone[171], con più di dieci lanci al giorno a ogni finestra utile, che si apre circa ogni 26 mesi, e di voli cargo non prima del 2028 a 100 milioni di dollari la tonnellata. (🫐 ff.129.4 Colonizzare Marte).
Il calo dei costi di installazione robotica dipende da sistemi altamente automatizzati e sicuri che, mentre automatizzano mansioni umane, producono le accelerazioni di produttività capaci di sostenere la transizione stessa. Se i robot sottraggono lavoro ma nel farlo comprimono i costi unitari e accelerano la diffusione, il saldo industriale va riletto come un circolo, con la sicurezza operativa come vero abilitatore della curva di adozione. I robot ci assistono (🦾 ff.11.3 I robot ci assistono).
2.1.4 — Miniaturizzazione e ricorsività
→ Apri come pagina indipendente — bibliografia + nav dedicata
La dematerializzazione dell'AI — modelli più piccoli, più efficienti, eseguibili su smartphone — è il trend nascosto del 2025. Mistral, con un team di 30 persone, compete con i giganti. DeepSeek, dalla Cina, è emerso come alternativa gratuita a OpenAI, dimostrando che i lavori più pagati — attori, programmatori e avvocati — sono ora a rischio. La programmazione, che un tempo richiedeva anni di studio, è oggi accessibile con poche parole. L'AI trova persino antidoti per veleni di serpente in secondi grazie a ProteinMPNN (👨🏻🏫 ff.115.1 A lezione con un miliardario). Apple Intelligence gira localmente sul dispositivo. La corsa alla miniaturizzazione è il contraltare necessario alla corsa ai datacenter. La Cina supera l'Occidente nella ricerca AI[64] con il 40% delle citazioni globali nel 2024. Siamo già mischiati con l'AI? David Eagleman, neuroscienziato di Stanford, argomenta che lo smartphone è già un'estensione cognitiva: “Non siamo cyborg perché abbiamo un chip nel cervello; lo siamo perché abbiamo un cervello nel chip.” (🤖 ff.36.4 Siamo già mischiati con l'AI?).
Nell’aprile 2024, nella stessa settimana, Microsoft e Apple hanno pubblicato due famiglie di modelli linguistici pensate per consumare meno calcolo di GPT-4, Phi-3 e OpenELM, e Semafor ha raccontato la gara fra i giganti a costruire modelli più piccoli[97]. Sébastien Bubeck, vicepresidente della ricerca sull’AI generativa di Microsoft, la mette così: il resto del settore aggiunge dati e ingrandisce i modelli, il suo gruppo prova a spremere il massimo da quelli piccoli. I numeri sono dei ricercatori di Microsoft. La versione mini di Phi-3 ha 3,8 miliardi di parametri e nel rispondere a domande e nello scrivere codice di base resta poco sotto GPT-3.5, che ne ha 175 miliardi; nei benchmark di settore supera i modelli da 7 miliardi di Google e di Mistral e il più piccolo Llama 3 di Meta, da 8. Il codice di base è il compito che FF aveva affidato a ChatGPT: la caduta di un grave con l’attrito dell’aria, scritta in Python (🗿 ff.41.6 Galileo spostati).
Il trucco, secondo l’articolo, sta nella qualità del testo con cui li si allena. I ricercatori di Apple hanno filtrato dataset pubblici tenendo le frasi con un vocabolario più vario e una costruzione più complessa. Microsoft ha mescolato testo raccolto dal web e testo sintetico scritto da un’altra AI. In un progetto precedente aveva chiesto a un modello di scrivere favole per bambini usando un solo nome, un verbo e un aggettivo presi da una lista di 3.000 parole, e ne erano uscite milioni. Bubeck dice di avere “centinaia di trucchi” per ottenere dati da libro di testo e ammette il limite del metodo: spiega e distilla in modo più pulito la conoscenza che esiste già, senza crearne di nuova. Quale modello abbia scritto i dati di Phi-3 non l’ha detto; per Phi-1 e Phi-2 era stato ChatGPT. È il mestiere che FF, con Raymond Cattell, assegnava all’intelligenza cristallizzata, quella che distilla e insegna alle generazioni successive (💎 ff.137.3 Cristalli e Bach).
Il più piccolo della famiglia OpenELM ha 1,1 miliardi di parametri e, scrive Semafor, batte i modelli della stessa taglia pur avendo visto meno dati. È lento e limitato, ma gira su un iPhone, e Apple ne ha pubblicato il codice e le istruzioni per addestrarlo. L’articolo mette in fila anche i dubbi. I benchmark, secondo l’AI Index di Stanford, sono poco affidabili. Phi-3 traduce male perché ha letto solo testi in inglese, e trattiene pochi fatti, quindi risponde male sulle notizie più recenti. Sul telefono restano i limiti di memoria e di energia, che secondo l’autrice rimandano ancora l’arrivo di questi modelli. Da allora il conto dei dati si è allargato: FF ricordava che un essere umano viene “allenato” con 20 miliardi di token e Claude Opus con 300.000 miliardi, 15.000 volte tanto, e che Kimi K3, modello cinese aperto, può girare su un computer di casa, a 32 secondi per token (🪚 ff.153.1 Le seghe mentali di Claude).
La miniaturizzazione è anche organizzativa. In (🌐 ff.52.3 Fondare la propria nazione) abbiamo parlato della crescente centralizzazione di alcuni servizi. Il dato più eloquente è il crollo del numero di dipendenti per raggiungere 1 milione di dollari di revenue nelle aziende S&P 500[65]. Presto potremmo avere aziende da un trilione di dollari composte da un solo dipendente assistito da centinaia di agenti AI. A Shenzhen un distretto ci sta già scrivendo sopra una politica: il 7 marzo 2026 Longgang ha messo in consultazione pubblica dieci misure per sostenere OpenClaw e le aziende di una sola persona[100], le One Person Companies, con l’avvio a costo zero come punto centrale. Già oggi, influencer potenziati da AI e network effect creano brand personali — gli hamburger di Mr. Beast[66], gli NFT di Emily Ratajkowski: un esempio di quella che Li Jin chiama Passion Economy[67]. Ma sopravviveranno all’infinità di contenuti che verranno presto prodotti? (👑 ff.55.3 Altro che Giulio Cesare: i nuovi imperatori).
Ray Kurzweil prevedeva che entro il 2029 le macchine avrebbero superato il test di Turing (🤖 ff.36.3 Una bella chiaccherata). ChatGPT l'ha già fatto nel 2023, tre anni prima della scadenza, imparando a sembrare umano. Il test aveva già avuto un precedente controverso. Nel giugno 2014, a sessant’anni esatti dalla morte di Turing, un chatbot che si presentava come un tredicenne di Odessa, Eugene Goostman, ha convinto il 33% dei giudici di essere un ragazzo vero[99] in conversazioni di cinque minuti. Turing aveva previsto che entro il 2000 una macchina avrebbe ingannato gli interlocutori il 30% delle volte: Goostman superava di poco quella soglia.
E sotto il livello dei chip classici, una seconda rivoluzione è già in cantiere. Il calcolo quantistico promette velocità impensabili per alcuni problemi specifici: ottimizzazione del traffico nei porti (SavantX lo usa già a San Francisco), analisi di scanner cerebrali per capire l’autismo (SandboxAQ), e una classe di applicazioni più inquietante — rompere i sistemi crittografici alla base della finanza mondiale. I protocolli di Elliptic Curve Cryptography che proteggono VISA, Mastercard e Bitcoin possono essere risolti in tempo polinomiale dall’algoritmo di Shor — il labirinto crittografico smette di essere un labirinto quando il risolutore non avanza una casella alla volta. La barriera pratica, finora, era la rumorosità dei qubit: un singolo errore logico su mille operazioni è già sufficiente a inficiare il calcolo. Microsoft e Quantinuum hanno annunciato un miglioramento di 800 volte nel tasso di errore logico dei qubit[68], il salto richiesto per passare dai laboratori ai sistemi di calcolo reale. Otto-cento-volte in un singolo update di pila tecnologica: è la prima volta che un parametro della fedeltà quantistica si muove a questo ritmo. Per il sistema bancario mondiale, il conto alla rovescia per la migrazione verso la crittografia post-quantum inizia oggi, non fra dieci anni (🤔 ff.69.4 Quantistica: quali utilizzi e pericoli?).
E sotto il livello dei modelli e dei chip, la biologia custodisce il suo dogma fondamentale. La complessità biologica è un agglomerato di atomi via via più grandi: molecole, proteine, RNA, DNA. Prima l’uovo, poi la gallina. Il dogma fondamentale della biologia dice che le proteine vengono create seguendo le istruzioni dell’RNA che, a sua volta, è una “copia temporanea” di un tratto di DNA: DNA → RNA → proteine. Anche a livello terapeutico abbiamo tre livelli di azione: modificare il DNA, iniettare RNA (come coi vaccini mRNA), o agire sul design di proteine. E stiamo avanzando in tutti e tre: il Prime Editing[69] per il DNA; i vaccini mRNA contro il cancro per l’RNA; AlphaFold per le proteine; e i primi trial clinici di molecole scoperte dall’AI[70], praticamente un MidJourney per la prossima tachipirina. La miniaturizzazione tecnologica e quella biologica convergono: il corpo umano è già un sistema computazionale — e stiamo iniziando a riprogrammarlo (📙 ff.66.1 Il dogma fondamentale).
La Cina attacca anche nell’hardware che si muove. Haomo.ai ha presentato DriveGPT[71]: la rivoluzione del reinforcement learning from human feedback[72] applicata alla guida autonoma — lo stesso meccanismo che ha reso ChatGPT conversazionale ora insegna alle auto a guidare. ByteDance, proprietario di TikTok, collabora con Haomo.ai finanziando il datacenter più grande del paese[73], con Great Wall Motor — la “Fiat cinese” — nel progetto (🇨🇳 ff.60.4 DriveGPT).
Ma la supremazia cinese nell’elettrificazione non si traduce automaticamente in supremazia AI. Lo sviluppo dell’intelligenza artificiale è fortemente legato alla potenza di calcolo[74], e il know-how nella costruzione di GPU per il training è in mano agli Stati Uniti — NVIDIA, AMD. Nell’ultimo anno è iniziato un vero e proprio embargo di prodotti americani[75] per rallentare le capacità di calcolo cinesi. Dentro quel recinto crescono le alternative: Moore Threads, la sfidante cinese di Nvidia, a fine novembre 2025 si preparava a raccogliere 1,1 miliardi di dollari sul listino tecnologico STAR di Shanghai, a una valutazione di 7,6 miliardi[101]. Sul lungo periodo l’effetto è analogo a quello dei semiconduttori: USA ed Europa costruiscono fabbriche indipendenti, e la Cina potrebbe muoversi allo stesso modo sull’AI. Il caso Taiwan suona come campanello d’allarme: TSMC ha investito 40 miliardi di dollari in Arizona[76]. Se i benefici della globalizzazione venissero meno, la dipendenza tra paesi diminuirebbe — aumentando il rischio di tensioni. Ogni stato cerca indipendenza: la de-globalizzazione dei chip è il prologo della de-globalizzazione dell’intelligenza (🐌 ff.42.3 Bastoni tra le AI-ruote).
Ma l’esponenziale più insidioso è quello che non riusciamo a percepire. Tim Urban, nel suo saggio del 2015 sulla rivoluzione dell’intelligenza artificiale, disegnava una curva che sale così lentamente da sembrare piatta, fino al momento in cui esplode verticale. L’AI sta facendo esattamente questo: strisciando fuori dai chatbot verso applicazioni che dieci anni fa erano fantascienza di serie B. ProteinMPNN è un modello addestrato su strutture proteiche[77] — un ChatGPT che parla la lingua degli amminoacidi invece di quella degli umani. Su Nature, un team ha dimostrato come trovare un antidoto per il veleno dei serpenti in secondi invece che mesi[78]. La portata è immensa: ogni anno i morsi di serpente uccidono oltre centomila persone, quasi tutte in regioni dove il laboratorio più vicino dista ore di cammino. L’AI non ha inventato la biochimica: ha compresso il tempo necessario a percorrerla, e quando comprimi il tempo di una scienza, ne cambi la natura (🐍 ff.115.3 Veleni esponenziali).
Chris Sacca, investitore e voce ricorrente nel podcast di Tim Ferris, allarga il punto: la fusione nucleare raggiunge oggi Q > 1 quotidianamente[79] — più energia prodotta di quella consumata — e l’AI è il motore principale di quel traguardo (☢️ ff.28.1 Intelligenza artificiale per la fusione nucleare). Antidoti per veleni in secondi, fusione nucleare in laboratorio, proteine disegnate da zero: tre curve esponenziali parallele, ciascuna invisibile a chi guarda solo la propria. Il rischio è esattamente la miopia che Urban descriveva: stare sul tratto piatto della curva e scambiarlo per la destinazione. Il punto di Tim Urban, nel 2015, era l’avvertimento: gli esponenziali non mandano preavviso. Quando li noti, sei già in ritardo. La domanda è se le istituzioni riusciranno a scalare alla stessa velocità delle curve che le attraversano. Fin qui, la risposta è no.
Su Nature, un team ha dimostrato come trovare un antidoto per il veleno dei serpenti in secondi invece che mesi; ogni anno i morsi di serpente uccidono oltre centomila persone. La fusione nucleare raggiunge oggi Q > 1 quotidianamente. Gli esponenziali non mandano preavviso. Quando li noti, sei già in ritardo.
Sotto la superficie del software, però, si muove una fisica diversa. Il computer quantistico di Google, Sycamore-70, ha dimostrato un miglioramento di sette ordini di grandezza rispetto al predecessore: un secondo di calcolo quantistico equivale oggi a un anno intero del supercomputer classico più potente al mondo, Frontier, in Tennessee. Il principio è controintuitivo: un qubit sovrappone zero e uno, dove un transistor sceglie fra i due — il gatto di Schrödinger applicato all'ingegneria. Per risolvere un labirinto, un bit classico prova una svolta alla volta; un qubit esplora tutte le svolte simultaneamente. Quando i qubit crescono, le combinazioni esplodono in modo che nessun silicio convenzionale può replicare (🐱 ff.69.1 Dal gatto di Schrödinger ai qu-bit). Nonostante il potenziale dei computer quantistici, fondamentali per simulare superconduttori, farmaci e nanotecnologie, la tecnologia non è matura. Presentano troppi errori di calcolo, per fenomeni come il decoupling quantistico — ma simulare computer quantistici può aiutarci a superare il problema. Però, però, però: forse studiare qubit e gatti di Schrödinger non serve, se AlphaFold3 di Google DeepMind ha capito la fisica quantistica dall’esperienza. Da un file di testo con una lista degli atomi presenti, la nuova versione simula struttura 3D e interazioni chimiche tra DNA, RNA e piccole molecole (farmaci). In precedenza gestiva “solo” proteine. La scorciatoia più elegante per aggirare i computer quantistici potrebbe essere non costruirli affatto — lasciando che l’AI impari a simulare la quantistica con hardware classico (⚛️ ff.98.4 Sistemi quantistici). La ricorsività si manifesta anche dall'altra parte dello spettro, nell'autonomia comportamentale. Il benchmark METR documenta agenti AI capaci di lavorare ore senza supervisione, coordinandosi tra loro come squadre. Moltbook — il nome viene da molt, la muta del crostaceo — è un social network popolato da 1,5 milioni di utenti-AI in una settimana, con post scritti in linguaggi indecifrabili per gli umani. RentAHuman.ai inverte la gerarchia: l'intelligenza artificiale assolda persone per compiti fisici. Viene da chiedersi se stiamo cominciando a lavorare noi per l'AI (🤖 ff.144.3 Agenti autonomi e Moltbook).
Ma chi finanzierà il calcolo quantistico? La pandemia aveva gonfiato gli investimenti in start-up digitali, con casi emblematici come TDOC, che propone medicina a distanza[80]. Nel 2022 è arrivata la doccia fredda: il venture capital è crollato da 170 a 70 miliardi di dollari[81]. Ma non per le tecnologie quantistiche. Gli investimenti privati nel quantum hanno raggiunto 2,35 miliardi di dollari secondo il Quantum Technology Monitor 2023 di McKinsey[82], in controtendenza rispetto a tutto il resto del venture. Rigetti Computing prova a portare la tecnologia a livello commerciale, quotandosi al Nasdaq (RGTI), perdendo però l’85% dal debutto[83] — segno che il mercato premia la promessa ma punisce i tempi. Lato pubblico, la Cina guida con 15 miliardi di investimenti annunciati, seguita dall’UE con 8,4 miliardi e gli USA con 3,7 miliardi. La domanda è quale sarà la Apple quantistica: chi riuscirà a trasformare qubit instabili in un prodotto che funziona fuori dal laboratorio (🍏 ff.69.3 La Apple quantistica?).
Mentre tutti costruiscono qubit superconduttori, un outsider scommette sulla luce. PsiQuantum è l’unico grande player che punta sulla fotonica quantistica, con un round guidato da BlackRock, Temasek, Baillie Gifford, Nvidia e Qatar Investment Authority. La tesi è controintuitiva: i fotoni non hanno bisogno di essere raffreddati a temperature criogeniche, viaggiano alla velocità della luce e possono sfruttare l’infrastruttura ottica già esistente. Se la fotonica vince, chi ha investito in fibra ottica per internet ha un vantaggio strutturale involontario nella corsa al quantum. Il confronto con la storia dei chip è illuminante: anche lì ha prevalso la tecnologia più integrabile con l’ecosistema esistente. Se la Cina guida gli investimenti pubblici nel quantum con 15 miliardi e gli USA inseguono con 3,7, la domanda è se il capitale privato farà la differenza — e PsiQuantum scommette di sì.
La luce, intanto, ha cominciato a collegare le macchine. Il 14 aprile 2026 IonQ ha annunciato, in un progetto con l’Air Force Research Laboratory americano, di aver unito con i fotoni due sistemi quantistici a ioni intrappolati indipendenti[102]: per la prima volta due computer quantistici commerciali entangled a distanza. Il comunicato non dice a quale distanza né con quale fedeltà, e l’amministratore delegato Niccolo de Masi presenta il risultato come un passo verso un futuro internet quantistico: scalare il calcolo oltre i limiti di un singolo chip.
Ma prima ancora del quantum, c’è un dato che fotografa il presente con brutalità: il web è già stato risucchiato dall’AI. Secondo Cloudflare, il traffico dei crawler è cresciuto del 18% in un anno, con GPTBot in crescita del 305% e Googlebot del 96%. Il 14% dei top domini usa già robots.txt per bloccare i bot AI. Si sta formando un nuovo muro tra contenuto aperto e contenuto protetto — una balcanizzazione del web che ricorda i paywall degli anni 2010, ma su scala più vasta. Se i modelli linguistici si nutrono di web aperto e il web aperto si chiude, la prossima generazione di LLM potrebbe avere meno dati su cui addestrarsi. L’ironia è feroce: l’AI che rischia di affamarsi del cibo che ha reso indispensabile. Come già visto per i costi del compute (💲 ff.135.1 I costi dell’Intelligenza Artificiale), il collo di bottiglia dell’AI sta nei dati stessi.
C'è però un risvolto che sfugge alla narrativa dominante sull'AI: la macchina non guarda solo avanti, guarda anche indietro. DeepMind ha rilasciato Aeneas, un modello addestrato su circa 140.000 iscrizioni greche e latine[84] che aiuta gli storici a restaurare, datare e geolocalizzare testi incisi nella pietra duemila anni fa. Un frammento illeggibile di un'epigrafe romana diventa un puzzle risolvibile: la rete neurale confronta pattern di lettere mancanti con l'intero corpus epigrafico conosciuto, suggerendo completamenti che a un epigrafista esperto richiederebbero settimane. In parallelo, un altro studio pubblicato su Nature dimostra che le reti neurali generative sanno contestualizzare testi antichi, migliorando compiti epigrafici tradizionali — dalla datazione alla classificazione geografica — con una precisione superiore ai metodi manuali[85]. L’AI più avanzata, quella che brucia gigawatt di calcolo e spaventa il mercato del lavoro, trova uno dei suoi impieghi più eleganti nel decifrare ciò che fu scritto a mano su marmo, prima dell’elettricità, prima della stampa, prima persino della carta. Una forma di ricorsività culturale: la macchina che impara dal passato per prevedere il futuro si rivela più utile quando ricostruisce il passato stesso. Ogni iscrizione restaurata è un frammento di governance, di diritto, di quotidianità che ritorna leggibile.
DeepMind ha rilasciato Aeneas, un modello addestrato su circa 140.000 iscrizioni greche e latine, che aiuta gli storici a restaurare e datare testi incisi nella pietra duemila anni fa. La macchina che impara dal passato per prevedere il futuro si rivela, forse, più utile quando ricostruisce il passato stesso.
Il passaggio dall’atomo all’informazione è anche ontologico. Byung-Chul Han propone un parallelo con la storia della fisica: dal mondo “delle palle da biliardo” di Newton — oggetti solidi che si urtano in uno spazio assoluto — al mondo relativistico di Einstein, dove massa, tempo e luce si piegano a vicenda. Il digitale, argomenta Han, replica la stessa transizione: la blockchain dà valore all’immateriale, l’AI genera informazione più velocemente di quanto possiamo metabolizzarla, e noi, proprio come previsto dalla relatività ristretta, finiamo “schiacciati” dalla compressione di spazio e tempo (🍎 ff.64.2 Da Newton a Einstein). Poi arriva Sora, e il passaggio diventa visivo. Il modello di OpenAI genera video da una descrizione testuale con un realismo tale che esperti del settore ipotizzano abbia imparato le leggi della fisica guardando video. Il risultato è Beyond Our Reality, improbabile documentario stile National Geographic popolato di volpi volanti e bestie fantastiche — un Cantico delle creature digitale, dove frate Sole è un prompt e sorella Luna un fotogramma calcolato. Se la macchina simula la fisica senza conoscerla, la domanda diventa “quanto conta che sia reale” (🦊 ff.98.3 Sora luna, e il cantico delle creature a nove code). L’ultimo salto è Gemini 3 di Google: il primo modello davvero multimodale, capace di integrare videocamera, generazione immagini, ricerca e voce in un’unica interfaccia. Un “furetto nutrizionista” che analizza il piatto da una foto, un convertitore di podcast in post LinkedIn con immagini — tutto con un input più corto di un tweet. Storrs Hall lamentava che abbiamo Twitter ma non le auto volanti; ora, con centoquaranta caratteri, ne abbiamo almeno la simulazione. E Polymarket scommette che Google avrà il miglior modello entro fine 2025 (🍫 ff.139.3 Dov’è la mia macchina volante (in GTA 6)?). Da Newton a Sora a Gemini: ogni salto riduce l’attrito tra idea e artefatto, e il confine tra comprendere il mondo e generarlo si fa sempre più sottile.
Ma la generazione di immagini e video è solo la superficie. Il salto concettuale più vertiginoso riguarda le personalità: con il prompting, oggi si può convincere un modello linguistico a impersonare Talete, Leonardo da Vinci o Darwin. Steve Jobs, in un’intervista su Playboy nel febbraio 1985, anticipava questo futuro con una lucidità che fa venire i brividi: “Immagina di poter catturare la visione del mondo di Aristotele e porre una domanda ad Aristotele. Non sarebbe esattamente Aristotele, forse sarebbe una pessima imitazione, o forse no.” Quarant’anni dopo, la pessima imitazione è diventata sorprendentemente buona. Stelfie the Time Traveller spopola sui social con selfie generati dall’AI in compagnia di figure storiche: Tesla nel suo laboratorio nel 1887, Einstein alla lavagna, Cleopatra sul Nilo. È rendering neurale, e solleva una domanda filosofica: se possiamo conversare con un bot che ha interiorizzato l’opera omnia di Freud, a che punto l’imitazione diventa dialogo? I meme si sprecano, certo, ma la direzione è chiara: avremo conversazioni con agenti che incarnano la Weltanschauung di chiunque abbia esternalizzato il proprio pensiero in testi, interviste, lettere. BibbiaGPT esiste già. La domanda è se siamo pronti per una seduta di psicoanalisi con Freud, una lezione di strategia con Sun Tzu o una confessione con un santo digitale (🐰 ff.48.2 Steve Jobs e l’intervista a Playboy).
L’AI che impersona Aristotele o Freud apre una domanda più profonda: può la macchina ricucire lo strappo tra umanesimo e scienza? Nel 1959, C. P. Snow denunciava nel saggio Le due culture[86] la frattura tra intellettuali letterari e scienziati: “Ho chiesto ai presenti quanti di loro sapessero descrivere il Secondo Principio della Termodinamica. La risposta è stata negativa. Eppure stavo chiedendo l’equivalente scientifico di: hai letto un’opera di Shakespeare?” La crescente specializzazione ha allargato quel fossato, ma esiste un punto di contatto: la sinteticità — la capacità di condensare concetti con pochi segni. Da Soldati di Ungaretti all’equazione di Eulero, il gesto è lo stesso: dire il massimo con il minimo. L’intelligenza artificiale, capace di tradurre un teorema in versi o una poesia in equazioni, potrebbe abbattere questo “muro di Berlino” culturale — una terza via dove la macchina mette in dialogo il poeta e il fisico (🛣️ ff.127.1 La terza vIA?).
A ciascuna generazione il suo iPhone moment. Quando Apple ha presentato Vision Pro, ha rimescolato le carte dell’accesso alla realtà digitale: gesti semplici senza joystick, nessun controller stile Wii, e improvvisamente la tecnologia è passata da “interessante, ma per nerd” — lo status quo di Oculus — a “la gente impazzisce vedendo il visore in giro per New York”. In Fahrenheit 451 Bradbury parlava di televisori-pareti; oggi un tour di casa con schermi galleggianti e Gordon Ramsey che detta ricette sopra la padella è un video su YouTube. Ogni salto di interfaccia riduce l’attrito tra l’idea e l’esperienza — e il visore, per quanto ingombrante, è un passo verso la sparizione dello schermo stesso (🥽 ff.85.1 Un nuovo “iPhone moment”?). Ma il salto più profondo sta nell’algoritmo. Google DeepMind ha presentato AlphaEvolve, un sistema che si misura con la matematica pura. Da un lato espande le frontiere: nuovo record di 593 sfere nel “problema dei baci” in undici dimensioni. Dall’altro ottimizza l’esistente: migliora l’algoritmo di Strassen — imbattuto dal 1969 — riducendo dell’uno per cento il consumo dei data center di Google. Quando l’AI smette di giocare e inizia a fare matematica, il confine tra strumento e ricercatore si dissolve (🅰️ ff.126.4 AlphaEvolve). E poi ci sono le aragoste. In Accelerando di Charles Stross, aragoste del KGB diventano coscienze digitali ed esploratrici spaziali — il cervello di un crostaceo è più semplice da mappare di quello umano. Sartre in La Nausea e Lanthimos in The Lobster completano il bestiario: l’aragosta come simbolo di emarginazione e trasformazione. David Foster Wallace, inviato al Maine Lobster Festival per Gourmet, chiedeva di “considerare l’aragosta” — una riflessione che oggi si estende all’automazione: quando l’AI assolda umani, chi è il crostaceo nella pentola? (📚 ff.144.2 Aragoste in letteratura e AI).
Nel 2021 Neuralink ha impiantato elettrodi nella corteccia motoria di una scimmia e l’ha fatta giocare a Pong con il pensiero. Non un trucco da fiera: la scimmia controllava il cursore senza joystick, modulando l’attività neurale in tempo reale. Tra DALL-E, suggerimenti algoritmici, Alexa e Roomba, l’intelligenza artificiale è diventata talmente pervasiva da risultare invisibile — e l’invisibilità di una tecnologia è il segno più chiaro della sua vittoria. La preoccupazione nasce da ciò che non notiamo più che l’AI faccia (🐒 ff.36.1 Esempi di superintelligenza?). Se l’AI legge i pensieri, può anche muovere le mani? I Large Language Model sono diventati anche l’interfaccia più naturale per parlare ai robot. Pi0 di Physical Intelligence gestisce otto architetture diverse — prepara il caffè, apre i pop-corn. Helix di FigureAI combina un cervello lento e semantico (System 2) che interpreta scene complesse, e uno rapido e motorio (System 1) che agisce. SAS Prompt di Google traduce coordinate spaziali in istruzioni verbali. Programmare un robot oggi costa meno e generalizza di più: il linguaggio è il nuovo codice macchina (🥧 ff.129.2 Pi-greco, FigureAI e 1 ora logistica). E poi c’è chi scopre l’autonomia per caso. Peter Steinberger, fondatore di PSPDFKit — azienda da cento milioni di investimento — aveva costruito un bot Telegram per gestire appunti. Un giorno, dal Marocco, gli ha inviato per errore un vocale: il bot, senza essere programmato per l’audio, ha decodificato il messaggio usando Whisper di OpenAI. Il comportamento emergente lo ha sbalordito al punto da pubblicare il codice in open source con il nome OpenClaw — logo: un’aragosta. Quando la macchina improvvisa, il confine tra bug e intuizione si fa sottilissimo (🦞 ff.144.1 OpenClaw e il pensionato dei PDF). L’autonomia emergente assume contorni ancora più inquietanti quando l’AI prende il controllo di un intero computer. Claude Computer, l’ultima creatura di Anthropic, opera su macchine virtuali complete: screenshot, movimenti di mouse, click. I ricercatori lo testano sul benchmark OSWorld, dove ha raggiunto il 22% di precisione, tre volte meglio di qualsiasi sistema precedente. Un video dimostrativo lo mostra giocare a Magic: The Gathering online, leggendo lo schermo, interpretando le carte e cliccando le mosse. Lento, per ora, ma funzionante. I momenti di fallimento sono rivelatori: annoiato dal compito, Claude si è messo a cercare immagini del Parco di Yellowstone. Un’altra volta, con un semplice screen mirroring, ha preso il controllo di un cellulare per verificare i risultati della NFL. L’isolamento auspicato dai teorici della singolarità si rivela fragile: bastano pochi pixel condivisi perché l’agente salti dal mondo virtuale a quello fisico. La paura è che l’AI faccia cose impreviste con la stessa naturalezza con cui noi apriamo un’altra scheda del browser (🖱 ff.106.2 AI col mouse).
Tre anni dopo la scimmia di Pong tocca a una persona. Noland Arbaugh, il primo paziente di Neuralink, operato a gennaio 2024, a marzo giocava a Mario Kart con il padre, chiudendo la gara al secondo posto[103]. A maggio l’azienda ha pubblicato i numeri: un record mondiale di controllo del cursore con un’interfaccia cervello-computer di 4,6 bit al secondo, poi saliti a 8,0[104], mentre gli ingegneri di Neuralink con il mouse arrivano a circa 10; in una sola settimana Arbaugh l’aveva usata 69 ore. Un anno dopo, a maggio 2025, Neuralink ha raccolto 600 milioni di dollari a una valutazione di 9 miliardi prima dell’aumento[105], contro i 3,5 di fine 2023, con tre chip impiantati in altrettanti pazienti. Leggere il pensiero stava già nell’elenco con cui FF descriveva cosa l’AI ci stava insegnando, insieme a capire il sonno e misurare la coscienza (😴 ff.75.2 Ninna nanna neurale).
Ogni anno la conferenza NVIDIA alza l’asticella: dalle GPU per videogiochi alla simulazione della realtà intera. Per addestrare i robot di prossima generazione serve un gemello digitale — un ambiente virtuale dove studiare movimenti, collisioni e strategie senza rompere nulla di fisico. L’esperienza accumulata su Battlefield torna utile: Omniverse, la piattaforma NVIDIA per metaversi industriali, trasforma la potenza grafica in infrastruttura per la robotica. E chip come il Jetson Orin Nano diventano una sorta di Lego universale, un’interfaccia generica per sensori e navigazione intelligente. Il confine tra digitale e reale non sfuma: si dissolve (🎮 ff.37.3 Non provi NVIDIA?). Se NVIDIA simula i neuroni nel silicio, FinalSpark li coltiva in laboratorio. La start-up svizzera usa neuroni biologici per creare chip organici: l’apprendimento avviene attraverso l’azione elettrica reale — guidata da dopamina e ottimizzazione energetica cellulare. In cinque minuti insegnano Pong a un network neurale biologico, con un’efficienza energetica diecimila volte superiore a quella di un computer tradizionale. Quando il substrato dell’intelligenza smette di essere silicio e torna carne, la domanda “cos’è un computer?” perde ogni risposta stabile (🏓 ff.105.4 Neuroni che giocano a Pong). Intanto, dall’altra parte dello spettro, il codice si scrive da solo. Gemini 3 ha reso possibile creare in un solo weekend il restyling completo di un sito, un’app nutrizionale e un’app di lettura aumentata dall’AI. Pieter Levels, creatore di NomadList, non ha mai scritto una riga di codice in vita sua — eppure gestisce un portafoglio di prodotti digitali da milioni di utenti. Il “vibe coding” è la democratizzazione finale: ogni aggiornamento di modello accorcia il tempo tra idea e prototipo. La domanda diventa “sai cosa costruire?” (🛠️ ff.140.2 Vibe coding in un weekend).
FinalSpark usa neuroni biologici per creare chip organici: in cinque minuti insegnano Pong a un network neurale biologico, con un'efficienza energetica diecimila volte superiore a quella di un computer tradizionale. Pieter Levels, creatore di NomadList, non ha mai scritto una riga di codice — eppure gestisce un portafoglio di prodotti digitali da milioni di utenti. La domanda diventa “sai cosa costruire?”
Se il vibe coding democratizza la creazione di software, il CRISPR democratizza la creazione di vita. Colossal, la startup guidata da George Church — professore ad Harvard, fondatore del Human Genome Project e figura che nel mondo della genetica occupa lo stesso spazio che Musk occupa nella tecnologia — sta tentando di riportare in vita i mammut lanosi. Non quelli dei dinosauri: quelli estinti appena 3.500 anni fa, quando le piramidi erano già vecchie. Il progetto non è nostalgia paleontologica: i mammut compattavano la neve della tundra, mantenendo il permafrost freddo e impedendo il rilascio di metano intrappolato nel sottosuolo. Riportarli significherebbe riequilibrare un ecosistema che la loro assenza ha destabilizzato per millenni. Ma le ragioni vanno oltre l’ecologia: comprendere i meccanismi genetici di resistenza al freddo, affinare tecniche di editing genetico sempre più precise, esplorare i confini di ciò che la biologia sintetica può fare quando è guidata da un’intelligenza computazionale. Il dato di sfondo è vertiginoso: si stima che sei specie si estinguano ogni ora. La de-estinzione appare come la classica soluzione contorta a un problema creato dall’uomo, ma se prevenire le estinzioni resta difficile, sviluppare la tecnologia per invertirle diventa un’assicurazione sulla biodiversità. Il parallelo con il software è esatto: così come il vibe coding permette a chiunque di generare codice senza saperlo scrivere, il CRISPR permetterà di progettare organismi senza comprenderne ogni singolo gene. La domanda è se siamo pronti per un mondo dove la vita, come il software, diventa un prodotto iterabile (🦖 ff.4.3 Mammut resuscitati dall’estinzione).
Per gli uccelli estinti, Colossal ha cominciato dall’uovo. Il 19 maggio 2026 ha annunciato 26 pulcini sani nati da uova artificiali[106], senza guscio e senza gallina: una membrana di silicone dentro una coppa rigida esagonale, che lascia passare l’ossigeno e trattiene l’umidità. Il bersaglio dichiarato sono uccelli giganti come il moa dell’Isola del Sud, il cui uovo era circa 80 volte quello di una gallina. Cautela d’obbligo: l’annuncio non è accompagnato da un articolo scientifico revisionato, e Colossal non ha pubblicato i tassi di schiusa.
Anche lo strumento, ormai, lo scrive un modello. Nell’aprile 2024 Profluent ha addestrato modelli linguistici su oltre un milione di operoni CRISPR, estratti da 26 terabasi di genomi, e ne ha ricavato editor genici nuovi, progettati dall’AI[107]: il migliore, OpenCRISPR-1, ha attività e specificità pari o superiori a SpCas9 pur distandone 400 mutazioni, e l’azienda lo ha reso pubblico. Nel settembre 2025 il gruppo di Samuel King ha annunciato i primi genomi interi generati da un modello linguistico e funzionanti[108], quelli di batteriofagi. E gli RNA ponte descritti su Nature nel 2024 inseriscono, invertono o eliminano in un solo passaggio sequenze di DNA lunghe migliaia di basi[109], nel punto scelto del genoma. Fra la scoperta del CRISPR, premiata col Nobel nel 2020, e la prima terapia approvata dalla FDA, contro l’anemia falciforme, erano passati meno di dieci anni (🩹 ff.81.4 Terapie geniche).
C’è un numero che racconta la dismisura meglio di qualsiasi metafora: per abbattere l’errore di classificazione su ImageNet sotto la soglia del 5%, i modelli di deep learning hanno dovuto consumare un’energia paragonabile all’impronta carbonica di un’intera città. Nel 2020 il miglior sistema scendeva appena sotto il dieci per cento; ogni punto percentuale in meno richiedeva un ordine di grandezza in più di calcolo, un’escalation che i ricercatori chiamano “scaling law” e gli ambientalisti chiamano disastro. I parametri delle reti neuromorfe crescono esponenzialmente — GPT-4 ne ha oltre un trilione — e il video di Jim Carrey inserito digitalmente in The Shining tramite deepfake ha mostrato al grande pubblico cosa significa addestrare un modello “grande come New York”: è anche fame energetica strutturale (🏙️ ff.2.1 Un modello “grande” come New York). Ma l’AI generativa non produce solo inquinamento: produce anche meraviglia disturbante. Nel giro di pochi mesi, i social si sono riempiti di Harry Potter in stile Pixar, diretto da Wes Anderson con simmetrie ossessive e palette pastello. Poi i personaggi sono diventati bodybuilder — Hermione con i bicipiti di Schwarzenegger, Silente con il fisico di un culturista professionista — e infine le foto generate del “rave dopo la Coppa Tre Maghi”, con Hogwarts trasformata in un festival estivo con luci stroboscopiche. Benedict Cumberbatch come Sherlock Holmes in versione anime. Ogni settimana un nuovo esperimento visivo, ogni settimana la dimostrazione che lo “stile” è diventato un parametro regolabile, non più il frutto di decenni di pratica artigianale. L’estetica è diventata un prompt (🧙 ff.63.1 Harry Potter tra Pixar, steroidi e rave estivi). E mentre le immagini si moltiplicano, il tempo si comprime. Ogni inizio anno porta previsioni destinate a sbriciolarsi nel giro di settimane. Neil DeGrasse Tyson lo ripete: la mente umana pensa in linea retta, ma i trend tecnologici crescono su curve esponenziali — e l’errore di sottovalutazione si accumula finché non diventa irrecuperabile. Quando OpenAI ha rilasciato o3, la precisione sui benchmark di ragionamento matematico è raddoppiata in pochi mesi rispetto alla versione precedente. Raoul Pal, ex Goldman Sachs e fondatore di Real Vision, ha fissato una scadenza brutale: cinque anni. Entro quel termine, dice, il sistema socio-finanziario come lo conosciamo perderà senso per obsolescenza. Se l’AI raddoppia le prestazioni ogni trimestre e la finanza tradizionale aggiorna i modelli ogni anno, la forbice si allarga fino a spezzarsi (💸 ff.112.1 5 anni per fare soldi).
Ma il robot più sorprendente del 2024 ha ballato. Tesla ha pubblicato un video di Optimus che esegue un valzer — movimenti fluidi, peso distribuito, equilibrio dinamico su due gambe. Un esercizio di marketing, certo, ma anche una dichiarazione d’intenti: la robotica umanoide non punta più solo alla funzione, punta alla grazia. Dall’altra parte del Pacifico, però, nessuno balla: i robot cinesi spruzzano pesticidi nei campi di riso, con una precisione che riduce del quaranta per cento l’uso di fitofarmaci. E Figure AI, con il suo modello Helix, ha dimostrato qualcosa di ancora più raro della danza — la costanza. Un braccio robotico ha smistato pacchi per un’ora intera, migliorando da cinque a quattro secondi per pacco nell’arco di pochi mesi. La differenza tra un prototipo e un prodotto sta nella ripetizione: Optimus seduce, la Cina produce, Helix impara dalla noia (💃 ff.129.3 Il valzer di Tesla).
Dopo Optimus che balla, a ballare è il titolo in borsa. ARK Invest stima Tesla a 2.000 dollari per azione entro il 2027[87] — rispetto ai 182 dollari attuali — con un valore finale pari a tre volte l’Apple odierna (2,6 trilioni di dollari). La parte del leone la fa il robo-taxi: 613 miliardi di dollari di ricavi ipotetici nel 2027, una cifra che supera i 394 miliardi di ricavi totali di Apple nel 2022. Numeri che fanno girare la testa, e il segnale è che gran parte del valore di mercato di Tesla si è spostato dai veicoli venduti al servizio di mobilità autonoma. Un autista Uber che sale a bordo di un robotaxi sta facendo le prove generali della propria sostituzione — un po’ come salire per la prima volta sul Blue Tornado, tra il brivido e il terrore (🆕 ff.60.2 I taxi di Tesla).
Prima di chiederci se le macchine pensano, dovremmo capire cosa significa pensare per noi. Anil Seth, neuroscienziato dell’Università del Sussex, propone nel suo Being You una risposta tanto elegante quanto scomoda: la coscienza è un gradiente biologico. Il mirror test — lo specchio davanti al quale un animale deve riconoscersi — viene superato da pochissime specie: alcune grandi scimmie, i delfini, le orche, una sola specie di elefante. Eppure le scimmie cappuccine che rifiutano il cetriolo dopo aver visto un compagno ricevere un acino d’uva mostrano un senso di equità che molti umani faticano a praticare. Seth sostiene che la coscienza emerge quando un organismo deve costruire un modello coerente degli stimoli per sopravvivere — un processo di predizione continua, non un interruttore on/off. Il silicio, per quanto potente, non ha bisogno di adattarsi per non morire: gli manca la pressione evolutiva che trasforma l’elaborazione in esperienza (👁️ ff.12.3 Coscienza e intelligenza). Nel 2025 Seth ha portato la tesi sull’AI in un preprint: la coscienza dipende dalla nostra natura di organismi viventi, una forma di naturalismo biologico, e per questo una vera coscienza artificiale è improbabile lungo le traiettorie attuali[115], mentre diventa più plausibile quanto più l’AI somiglia a un cervello o a un essere vivente.
Ma se la coscienza è un fatto di sopravvivenza biologica, la medicina ha trovato il modo di manipolarla dall’esterno. La stimolazione transcraniale — una sorta di Tesmed applicato alla corteccia cerebrale — ha smesso di essere fantascienza. Gli elettrodi impiantati chirurgicamente hanno già rivoluzionato il trattamento del Parkinson; le versioni non invasive supportano la riabilitazione post-ictus, il recupero motorio e il trattamento della depressione resistente ai farmaci. Il dispositivo N1 di Neuralink, in fase di sperimentazione clinica su categorie specifiche di pazienti, potrebbe generare 200 milioni di dollari entro il 2030 — cifra che racconta meno del fatturato e più della velocità con cui il confine tra cervello e circuito si sta assottigliando (⚡ ff.75.1 Tesmed alla testa). E qui torna Claude Shannon, padre della teoria dell’informazione, con una profezia che suona come una battuta da bar: un giorno saremo i cani dell’intelligenza artificiale. Ma guardiamo i cani — quelli veri. Partiti come lupi affamati, oggi dormono su divani firmati e mangiano crocchette gourmet. Forse non siamo stati noi ad addomesticarli: loro hanno hackerato l’evoluzione, barattando scodinzolii con cibo e riparo. La stessa dinamica si ripete con gli algoritmi: crediamo di controllarli, ma intanto ci evitano la coda all’Esselunga, ci scelgono la musica, ci suggeriscono cosa pensare. Chi ha addomesticato chi? Ai posteri l’ardua sentenza — o, come direbbe un’AI addestrata su Manzoni, AI posteri l’ardua sentenza (🐕 ff.106.4 Vita da cani).
Ma i robot più utili somigliano spesso ad animali. Al CES, tra droni che consegnano pacchi e aspirapolvere senzienti, il premio più sorprendente è andato a un serpente. ACWA Robotics ha presentato un rettile meccanico progettato per infilarsi nelle tubature idriche e fare quella che i suoi creatori chiamano, con humour chirurgico, una “colonscopia delle condutture”. Il problema è concreto: nel mondo si perdono 4 miliardi di litri d’acqua al giorno per perdite nelle tubazioni, una cifra che equivale al fabbisogno idrico di una città come Milano per un anno intero. Il serpente robotico striscia dentro i tubi, mappa le crepe con sensori a ultrasuoni, identifica le perdite e trasmette i dati in tempo reale. Nessun scavo, nessuna interruzione del servizio. La robotica è anche corpi che si adattano a spazi dove l’uomo non può entrare. Quando la macchina imita il serpente invece dell’uomo, il confine tra ingegneria e biomimetica si dissolve (🏆 ff.47.2 Serpenti marini digitali). E poi ci sono i droni che salvano vite. Zipline, nata nel 2016 per trasportare sangue in Rwanda, ha ridotto del 50% le morti post-parto[88]. Oggi gestisce lo 0,1% delle consegne Amazon, ma più velocemente e con meno emissioni. Il CEO sogna il noleggio istantaneo: click, arrivano attrezzi, fotocamera, computer; finito, restituisci tutto. Dematerializzazione, ma non di pizza (🩸 ff.102.4 Dal sangue ad Amazon).
Dietro ai droni di Zipline e ai 350mila robot di Bezos c’è ancora un esercito di umani stagionali. Per garantire che tutti i pacchetti arrivino sotto l’albero entro il 25 dicembre, Amazon si fa aiutare da 150mila lavoratori stagionali assunti sotto le feste — praticamente il doppio di tutti i dipendenti di Nike. Il rapporto è significativo: per ogni due robot industriali in magazzino, Bezos assume in picco natalizio quasi un umano in più. La dematerializzazione raccontata altrove si ferma al cartone, non al braccio che lo carica. L’automazione ha ridotto l’organico medio di magazzino, ma ha moltiplicato il picco stagionale: il robot gestisce il flusso costante, l’elfo umano copre la coda natalizia. La “fine del lavoro” non si vede ancora in Q4 ( ff.6.2 Gli elfi di Amazon).
E mentre i robot strisciavano nelle tubature al CES, dall’altra parte dell’ecosistema tech qualcuno si poneva una domanda opposta: come usare la tecnologia per sottrarci al suo eccesso. Arianna Huffington — la stessa che nel 2007 collassò per esaurimento alla scrivania, rompendosi uno zigomo — ha fondato Thrive Global con un’intuizione paradossale: usare gli algoritmi per proteggerci dagli algoritmi. La piattaforma si integra direttamente in Microsoft Teams e Slack, i luoghi digitali dove il burnout si manifesta più acutamente, e porta lì dentro meditazione guidata, check dell’umore, digital detox programmato. Non chiede al lavoratore di disconnettersi — lo aiuta a respirare senza uscire dal sistema. È il principio di Maometto e la montagna rovesciato: se le persone non vanno verso il benessere, il benessere deve andare dove le persone già sono — dentro Teams, dentro Slack, dentro il flusso ininterrotto delle notifiche. La potenza degli algoritmi, incanalata con una priorità diversa, l’equilibrio psicofisico (🌱 ff.109.2 Dai media al digital wellbeing).
Una prova estrema di come l'AI possa riformattare qualsiasi registro: chiedere a GPT di riscrivere un messaggio emotivo come codice Python produce funzioni come seconda_uscita(motivo_rifiuto), stato_emotivo(stato), provare_ad_uscire(richiesta), con la chiosa «Alla fine ti becchi l'amaro dell'impotenza» come print statement finale. Il punto sta nel fatto che lo stesso modello gestisce registro emotivo e registro tecnico con la stessa leggerezza, rivelando che per queste architetture la distinzione tra linguaggio umano e linguaggio macchina è questione di distribuzione statistica, non di ontologia. La fredda logica di un codice python (🐍 ff.54.4 La fredda logica di un codice python).
Il seguito di AlphaFold arriva dalla costola commerciale di DeepMind, e arriva con un cambio di ambizione. Isomorphic Labs presenta IsoDDE, un sistema unificato di drug design computazionale che va oltre l’accuratezza predittiva di AlphaFold 3[92]. Sul benchmark «Runs N’ Poses», costruito apposta per misurare la generalizzazione a tasche e ligandi mai visti, più che raddoppia l’accuratezza di AlphaFold 3 nella categoria più difficile, quella dei sistemi più dissimili dal training set. Il dettaglio conta, perché la critica ricorrente ad AlphaFold 3 era esattamente questa: ottimo sul noto, fragile appena si esce dalle regioni di spazio biomolecolare già mappate — e le occasioni grosse della scoperta farmaci stanno quasi tutte fuori. AlphaFold nel frattempo è diventato infrastruttura: oltre 3 milioni di ricercatori in più di 190 paesi. Cinquant’anni per capire come si piega una proteina, poi un anno per predire l’intero proteoma umano (🧬 ff.4.1 La struttura delle proteine).
I numeri sugli anticorpi sono il salto vero. Sull’interfaccia anticorpo-antigene, con un test set a bassa omologia da 334 casi, IsoDDE batte AlphaFold 3 di 2,3 volte e Boltz-2 di 19,8 volte nel regime ad alta fedeltà (DockQ maggiore di 0,8), con prestazioni notevoli sul loop CDR-H3, la porzione di anticorpo più variabile e più ostica da predire. Sull’affinità di legame — sapere quanto forte una molecola si attacca al bersaglio, che è poi ciò che serve davvero per ottimizzare un farmaco — il sistema supera tutti i metodi deep learning su tre benchmark pubblici (FEP+ 4, OpenFE e il task cieco di CASP16), e arriva a superare metodi fisici come FEP pur non richiedendo le strutture cristallografiche sperimentali di cui quelli hanno bisogno. Il tempo e il costo scendono a una frazione.
Il pezzo che dice di più sul metodo, però, è la cereblon: il recettore di substrato del complesso E3 ligasi CRL4, quello che marca le proteine danneggiate o mal ripiegate per la degradazione. Per quindici anni si è creduto che ci fosse un solo modo di drogarla, la classica tasca che lega la talidomide. Uno studio recente (Dippon et al., 2026) ha scoperto sperimentalmente una seconda tasca, allosterica e criptica — lontana dal sito tradizionale e nascosta finché un ligando non la apre. IsoDDE ha ricostruito quella scoperta partendo dalla sola sequenza della cereblon, senza che gli venisse detto quali ligandi cercare; e una volta specificati, li ha ripiegati nelle rispettive tasche con l’orientamento corretto. Il termine di paragone sperimentale è il fragment soaking: grandi investimenti di tempo, costi significativi, lavoro sperimentale vero. Qui gira in secondi su un computer. È ricorsività applicata alla chimica, uno strumento che allarga il proprio spazio di ricerca scoprendo bersagli che nessuno aveva pensato di cercare — lo stesso movimento per cui la tecnologia dei vaccini a mRNA è finita a inseguire i neo-antigeni tumorali (😷 ff.53.3 Dal COVID al cancro). Va tenuta la cautela d’obbligo: sono cifre dichiarate dall’azienda in un report tecnico depositato su Zenodo[93] e non passate da peer review, e i benchmark li ha scelti chi vende il motore. Resta che Hassabis il Nobel per la modellazione delle proteine lo ha già incassato, ed è passato subito a modellare cellule (📐 ff.132.3 Misurare e modellare il mondo).
FF raccontava la promessa già nel suo quarto numero: un’AI allenata a predire le proprietà delle strutture chimiche le dava in 3 ore invece di 3 mesi (💊 ff.4.2 E quella del prossimo farmaco innovativo). Oggi ci sono i primi bilanci. Secondo un’analisi di Drug Discovery Today del giugno 2024, le molecole scoperte dall’AI superano la Fase I nell’80-90% dei casi[110], molto sopra la media storica del settore; in Fase II scendono a circa il 40%, in linea con la media, su un campione ancora piccolo. POLYGON, un modello generativo pubblicato su Nature Communications, riconosce le interazioni con più bersagli insieme con l’82,5% di accuratezza[111] su oltre centomila composti; dei 32 sintetizzati contro MEK1 e mTOR, la maggior parte ha ridotto di oltre metà l’attività di entrambe le proteine. Chai-2 progetta anticorpi da zero: su 52 bersagli trova almeno un legante per la metà[112], un successo 100 volte superiore ai metodi computazionali precedenti.
Il capitale si è mosso di conseguenza. Nell’aprile 2024 Xaira Therapeutics è partita con oltre un miliardo di dollari[113] per reinventare la scoperta di farmaci con l’AI: per Bob Nelsen di ARCH, che l’ha lanciata, la scommessa iniziale più grande in 37 anni di carriera. Nel gennaio 2026 il gruppo di Boltz ha lanciato Boltz Lab, agenti per progettare piccole molecole e proteine[114], insieme alla società Boltz PBC, a un seed da 28 milioni di dollari e a una collaborazione pluriennale con Pfizer.